Effective STL 现代重读
《Effective STL》(Scott Meyers,2001,50 条)讨论的不是“标准库有哪些接口”,而是“怎样使用这些接口才正确、高效且可维护”。它成书于 C++98:当时没有移动语义、unique_ptr、标准哈希容器和 ranges,甚至需要解释为什么不能把 auto_ptr 放进容器。二十多年后,容器不变量、迭代器失效、严格弱序和算法前置条件依然成立,手写适配器、旧分配器限制和迭代器转换技巧则已被新接口替代。
本文是 Effective C++ 与 More Effective C++ 现代重读 的姊妹篇,按原书七章、50 条的顺序,以现代 C++(C++11–C++23)重审每条建议:保留有效的机制解释,指出已过时的具体做法,给出今天更直接的写法。条款编号与主题以出版社目录为准;本文是现代实践评述,不是原书译文。remove / erase 的区别集中在 Item 9、32、33。
每个条款标题前的状态标签说明这条建议在现代 C++ 中该怎么用:
- 仍适用:机制与原则仍成立,结合现代语法继续使用。
- 需更新:问题仍在,但已有更直接的接口或不同的实现策略。
- 已过时:旧设施或技巧不再适合作为通用建议,改用正文中的现代做法。
代码块各自独立,主要采用 C++20;正文标注较早或较新的设施版本。语言标准与库支持是两件事,C++23 的 flat_map 等设施还需检查目标标准库的特性宏。下面的“仍适用”不表示旧代码应原样复制,“已过时”也不表示原条款关注的风险已经消失。
容器:选择、所有权与删除
仍适用 Item 1:慎重选择容器
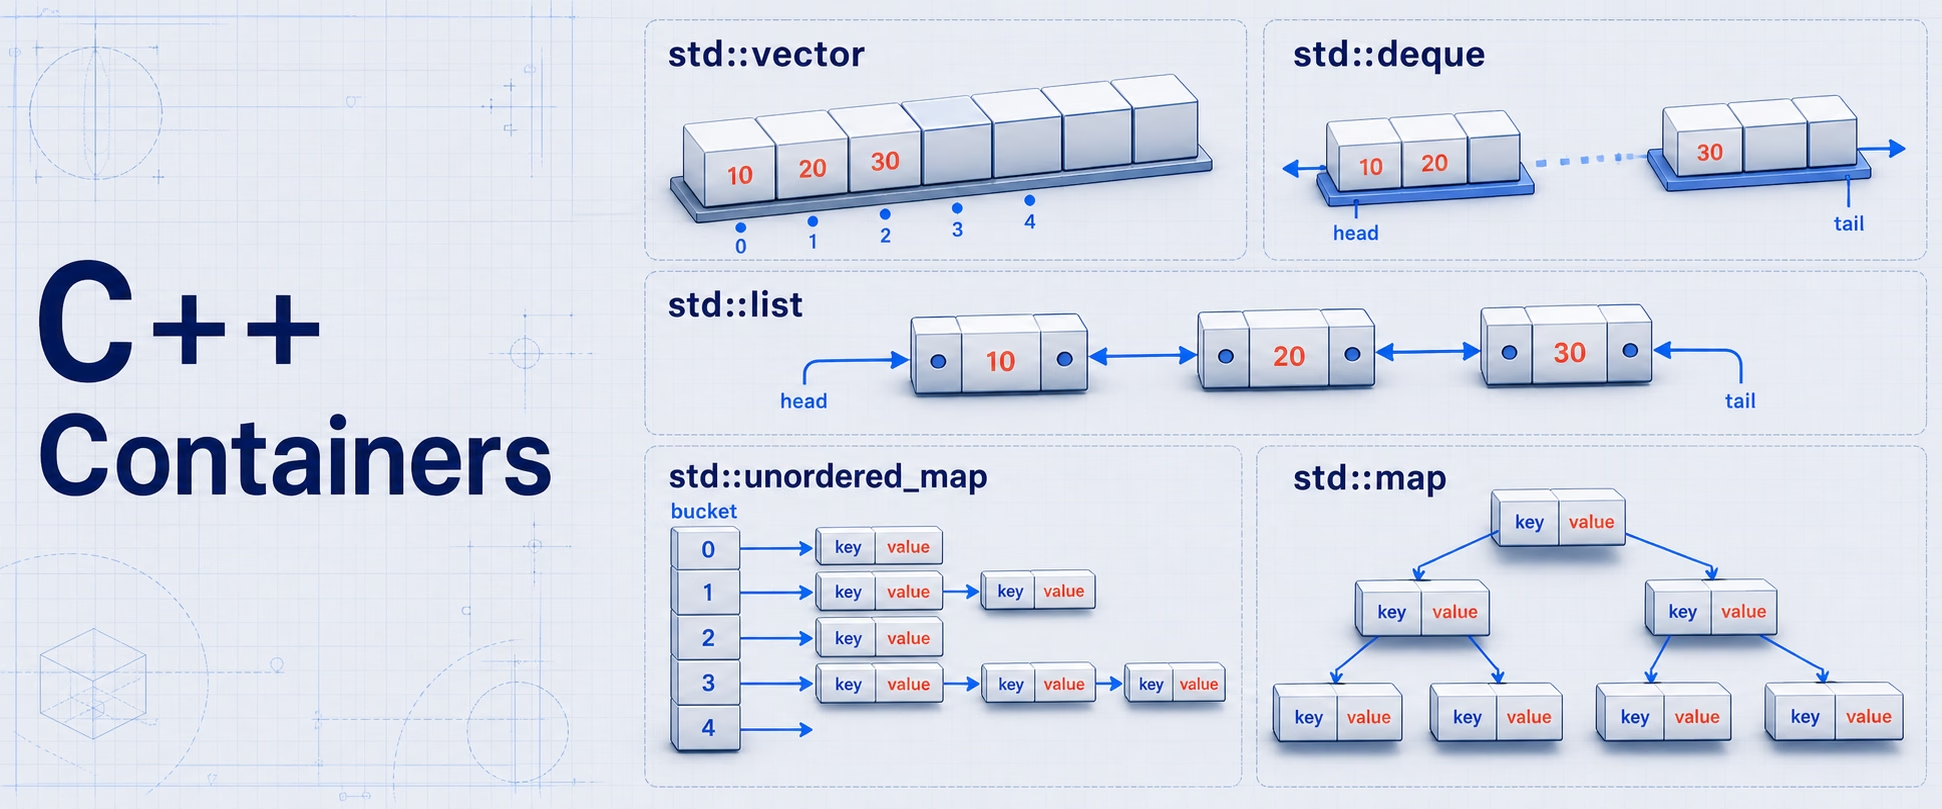
容器选择首先是语义选择,然后才是复杂度选择:是否需要排序、随机访问、稳定的元素地址、两端增长,以及插入后还能否使用已有句柄,都会约束方案。没有特殊要求时从 std::vector 开始;连续布局通常比节点容器更节省分配和缓存访问成本。list 的常数时间插入以“已经持有正确位置的迭代器”为前提,找到位置仍可能是线性操作,不能仅凭复杂度表把它当成更快的 vector。
| 主要需求 | 优先考虑 | 必须接受的边界 |
|---|---|---|
| 连续存储、随机访问、尾部增长 | vector | 重分配使全部元素句柄失效,中间插入通常线性 |
| 两端频繁增删 | deque | 不保证整体连续;尾部插入可能使迭代器失效,不能把迭代器与引用的规则混为一谈 |
| 固定大小的拥有型序列 | array(C++11) | 大小属于类型,不能动态增长 |
| 有序查找、增量修改、稳定节点 | map / set | 节点分配与指针跳转;不能通过迭代器修改键 |
| 不需要顺序的快速查找 | unordered_map / unordered_set(C++11) | 平均常数时间,最坏线性;rehash 使迭代器失效,但不使元素引用、指针失效 |
| 已知位置的节点迁移与稳定地址 | list / forward_list | 不支持随机访问,节点开销较大;跨容器 splice 有分配器兼容要求 |
| 只借用连续数据 | span(C++20) | 不是拥有型容器,不能延长数据寿命 |
C++23 的 flat_map / flat_set 也适合批量构建后读多写少的数据,但不是节点容器的无缝替代:中间插入需要搬移元素,失效规则也不同。使用前检查 __cpp_lib_flat_map >= 202207L / __cpp_lib_flat_set >= 202207L,不能把语言模式当作库实现已支持的证据。
1 | |
仍适用 Item 2:警惕容器无关代码的幻觉
统一的成员名不等于统一的契约:vector::erase 会搬移后续元素,list::erase 销毁节点,map::erase 按位置或键删除;迭代器失效和复杂度也不同。把容器藏进一个 using 声明,并不能保证替换类型后程序仍然正确或保持性能。真正有用的泛型代码应说明自己需要什么能力,而不是声称接受“任意容器”。
C++20 的 concepts / ranges 可以把“输入区间”“随机访问区间”“连续区间”等要求写进接口,但表达式能编译仍不意味着所有行为契约都已被检查。只需读取连续整数时,std::span<const int> 就能把接口与 vector、array 等具体所有者解耦;它明确拒绝 list,也明确表示不拥有数据。需要排序或修改容器结构的接口则应保留相应要求,不要为了通用而隐藏它们。
1 | |
需更新 Item 3:让容器中对象的拷贝便宜且正确
原条款关注插入、重分配和算法中发生的对象复制;现代重读还必须加入移动。容器保存的是元素对象,而不是原对象的别名:复制应保持值语义,不能浅拷贝一个拥有型裸指针后让两个对象重复释放资源;把派生对象按值放入 vector<Base> 仍会切片。默认优先零规则,由 string、vector、智能指针等成员管理资源;只有确需共享所有权时才使用 shared_ptr,不要为了让复制变便宜而偷偷改变对象语义。
vector 扩容时通常通过不抛异常的移动搬迁元素;若移动可能抛异常而复制可用,常见实现会选择复制,以保持强异常保证。只有移动确实不抛时才能标记 noexcept,否则异常会触发 std::terminate。不可复制但可移动的元素仍可用于许多容器操作,不过若其移动抛异常,某些扩容操作的异常保证会减弱;emplace_back 也不能消除已有元素在重分配时的搬迁。
1 | |
仍适用 Item 4:判断是否为空时使用 empty
empty() 直接表达“是否有元素”,不要求计算元素总数。原书提到部分 list 实现的 size() 可能是线性的;C++11 起标准 list::size() 已要求常数复杂度,因此不能继续拿这个历史事实解释现代 list。原则仍成立:forward_list 根本没有 size(),通用区间的计数也可能需要遍历,甚至消耗单遍输入。
C++17 的 std::empty 可以统一处理有 empty() 的容器、内建数组等对象;C++20 ranges 代码可以使用 std::ranges::empty,但它也有能力约束,并非所有单遍输入区间都支持。判断为空不是同步操作:共享容器上“检查非空再取元素”仍需要一个覆盖两步的锁,见 Item 12。
1 | |
仍适用 Item 5:优先使用区间成员函数
知道要插入、赋值或删除一整段数据时,直接使用区间构造、assign(first, last)、insert(pos, first, last)、erase(first, last),比循环调用单元素操作更清楚,也给容器一次规划分配和搬移的机会。特别是向 vector 中间逐个插入或逐个擦除,同一批后续元素可能被反复搬移;区间操作能避免这种无谓重复。
这不是“一定只分配一次”的承诺:单遍输入迭代器不能总在不消耗输入的情况下提前获知长度。还要遵守接口的重叠要求,不要把 vector 自身的迭代器作为其区间插入的来源;重分配与自引用都可能破坏前提。C++23 增加 assign_range、insert_range、append_range 等容器区间接口,适用前检查 __cpp_lib_containers_ranges >= 202202L;并非每种容器都具有相同的一组成员。
1 | |
需更新 Item 6:警惕最令人困惑的解析
C++ 在一个声明既能解释为对象定义、又能解释为函数声明时,选择函数声明。经典的 T object(); 声明的是函数;嵌套的临时迭代器构造也可能让容器声明被误读。C++11 的花括号初始化能避开这类歧义,也可以先给迭代器命名,再使用无歧义的区间构造。
但不要把“改用花括号”当成机械替换规则。vector<int>(3, 7) 表示三个 7,vector<int>{3, 7} 表示两个元素 3 和 7,因为可行的 initializer_list 构造优先。修复解析问题时必须保留原本想调用的构造函数语义。
1 | |
需更新 Item 7:容器中的 new 指针必须有明确的所有权
原书要求在指针容器析构前逐一 delete;现代写法应从源头去掉这项手工责任。容器析构只会析构其元素:vector<T*> 的元素是地址,不会自动销毁所指对象;中途抛异常、提前返回或删除某个元素时,集中在函数结尾的清理尤其容易漏掉。优先直接存储对象;确需独立对象地址、动态多态或独占堆对象时,使用 vector<unique_ptr<T>>,由元素析构负责释放。
make_unique 从 C++14 起提供;它在对象进入容器之前就建立 RAII 所有权,即使容器插入失败也不会泄漏。用于多态对象时,基类析构函数应是虚函数。相反,T* 容器可以合法地表示观察者,但必须保证外部所有者的寿命覆盖每次访问,不能既把它当借用,又在容器清理时释放对象。
1 | |
已过时 Item 8:不要创建 auto_ptr 容器
这是针对已移除类型的历史禁令,而不是对智能指针容器的禁令。auto_ptr 的“复制”会转移所有权并修改源对象,不满足当时容器要求的普通复制语义;它在 C++11 被弃用、C++17 被移除。现代独占所有权使用 unique_ptr:复制明确禁止,转移明确通过移动发生,vector<unique_ptr<T>> 是正常、常用的设计。
仍要区分容器支持与具体操作的要求:不能复制这种 vector,要求复制元素的构造或赋值也不可用。尤其不要写 vector<unique_ptr<T>>{...} 来期待移动每个初始化项;initializer_list 的元素是 const,常规列表构造需要复制它们。先创建容器,再 push_back(make_unique(...)),或显式移动现有拥有者。
1 | |
需更新 Item 9:慎重选择删除方式
不要把 erase-remove 当成所有容器通用的删除模板;不同容器的元素可修改性、移动成本和删除接口不同。C++20 的非成员 std::erase / std::erase_if 把常见模式统一得更清楚,但仍按具体容器提供不同重载,并非任何区间都能缩小。
| 容器 | C++11–C++17 常用做法 | C++20 起优先做法 |
|---|---|---|
vector、deque、string | erase-remove / erase-remove_if | std::erase(c, value) / std::erase_if(c, pred) |
list、forward_list | 成员 remove(value) / remove_if(pred),直接删除节点 | 同样可用 std::erase / std::erase_if,按节点删除 |
set、map 及其 unordered / multi 版本 | 按键用成员 erase(key);按条件遍历删除 | 按键仍用成员 erase(key);按条件用 std::erase_if(c, pred) |
array、span(C++20) | array 只能压缩区间,另行保存逻辑长度 | 二者都不能改变大小;没有对应的 std::erase / std::erase_if |
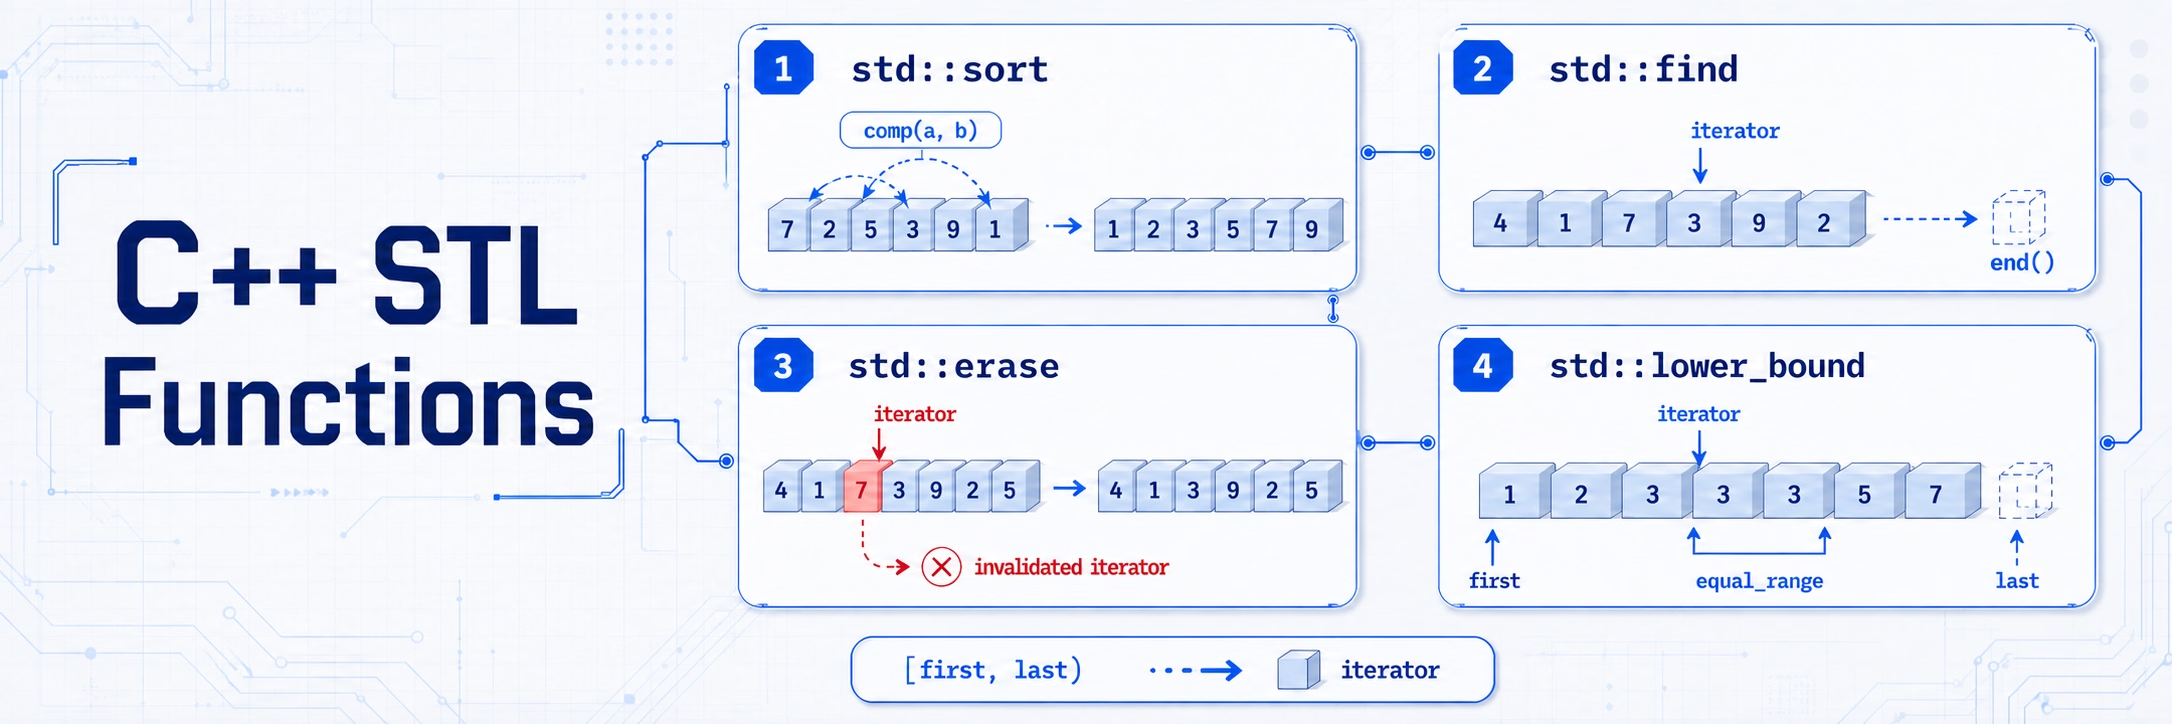
list::remove 与 std::remove 名字相同、行为不同:前者真正销毁节点,后者只给元素赋值。关联容器不能套用 erase-remove:set 的元素、map 元素的键不可赋值,无法按算法要求向前移动;map 的删除谓词接收键值对,不是单独的键。remove 的逻辑末尾、尾部状态和压缩机制集中在 Item 32 解释,这里只保留选择删除接口时必须守住的边界。
- 要擦除整个尾部:
c.erase(new_end, c.end()),不是c.erase(new_end)。后者只删一个元素;若没有匹配项,new_end == c.end(),单元素擦除end()不合法,而空区间擦除合法。 - 遍历删除要接住返回值:对提供
erase(it)的这些标准容器,删除分支用it = c.erase(it),未删除分支才++it;不要在已失效的迭代器上继续递增,也不要缓存可能失效的旧end()。forward_list使用erase_after,需要保存前驱;单纯按条件批量删除vector时优先std::erase_if,逐个擦除反复搬移元素,最坏会退化为 。 - 位置有效不代表元素身份不变:
remove不改变容器大小,但会给已有位置赋新值;之后vector::erase使擦除起点及其后的迭代器、引用和指针失效,包括旧end()。不能拿删除前的句柄继续追踪原元素。 - 比较值不要借用待修改区间:
std::remove(first, last, xs[0])的value是引用,压缩可能改写xs[0],导致后续比较目标变化;std::erase(xs, xs[0])对vector也有同样风险。先用auto value = xs[0];保存独立值,再删除;谓词捕获的比较目标也应保持稳定。 - 删除不等于释放容量:
vector的 erase-remove、std::erase、std::erase_if都不缩小capacity()。shrink_to_fit()只是非强制请求,若发生重分配,所有元素句柄都会失效,见 Item 17。
1 | |
需更新 Item 10:了解分配器的约定与限制
原书为早期实现给出的限制不能直接当作现代标准规则:C++11 起有状态分配器受到正式支持,allocator_traits 统一提供成员类型、分配、构造、销毁和 rebind 的适配。allocate(n) 中的 n 是对象数量,不是字节数;得到的是存储,不等于已经构造了对象。容器的元素类型须与分配器的 value_type 一致;节点容器还可能把分配器重绑定为内部节点类型。旧式手写代码不应依赖已在 C++20 从 std::allocator 移除的 construct、destroy、rebind 成员,改用 traits 接口。
分配器相等的含义不是“状态字段碰巧相同”,而是它们分配的存储可以互相正确释放。这个契约决定能否直接接管内存:携带指定分配器的移动构造,在分配器相等时可直接接管;不等时可能需要逐元素移动。复制、移动赋值和交换是否连同分配器一起操作,由各自的传播 traits 决定;不能假设容器换了内容,分配器也必然跟着换。具体约束见分配器感知容器要求。
1 | |
需更新 Item 11:理解自定义分配器的合理用途
合理需求包括为一批短命对象使用 arena、复用节点分配、控制分配预算,以及记录分配行为;不是借分配器改变元素值、排序规则或替代对象自己的 RAII。C++17 的 std::pmr 将分配策略放到 memory_resource,让同一种 pmr::vector<T> 在运行时选择资源,通常比自行实现完整 allocator 更直接。monotonic_buffer_resource 适合整体释放的批次:单次 deallocate 不回收存储,容器反复扩容会暂时保留旧缓冲,因此已知数量时仍应先 reserve。指定 null_memory_resource() 为上游可限制在预置缓冲内,耗尽时抛 bad_alloc,而不是悄悄转向堆分配。
资源不拥有使用它的容器;资源及其外部缓冲必须比容器和依赖它的元素活得更久,不能在容器仍然存活、仍可能访问存储时调用 release()。嵌套分配也必须审查:pmr::vector<std::string> 的普通字符串不会自动转向该资源,而 pmr::vector<pmr::string> 能通过 uses-allocator 构造传播资源。下面按“缓冲、资源、容器”的顺序声明,析构顺序正好相反。
polymorphic_allocator 不在复制赋值、移动赋值、交换时传播资源;普通复制构造又默认选择当前默认资源,并非原资源。需要沿用资源时显式传入分配器;资源不同且不相等的两个 pmr 容器不能直接 swap,否则违反前提、产生未定义行为。跨资源移动赋值也可能逐元素移动,不能一概当成常数时间指针交换。
1 | |
仍适用 Item 12:对容器的线程安全抱有现实预期
标准容器不是并发容器。不同容器对象通常可以独立操作;同一个容器的只读操作可以并发;在不改变结构的前提下,并发修改不同元素也有保证,但 vector<bool> 是明确例外,因为不同逻辑位可能共享同一个存储单元。元素对象自身的共享状态也必须另外同步:两个不同元素若指向同一可变对象,容器规则不会消除该对象的数据竞争。标准把部分非 const 访问成员在数据竞争意义上视为只读,但 map / unordered 容器的 operator[] 不属于这一保证,因为它可能插入。
任何可能与读写冲突的结构修改都必须同步,不能把“这次 vector 没有扩容”当作无锁 push_back 的许可。尤其是“检查非空,然后取出并删除”这样的复合操作,锁必须覆盖整个逻辑;分别给每个调用加锁仍会让检查结果过期。锁内得到的引用、迭代器或 data() 指针若逃到锁外,之后另一线程修改容器仍可能使其失效。下面返回独立值,而不是借用句柄;标准的容器数据竞争条款给出了不同元素与 vector<bool> 的明确边界。
1 | |
vector 与 string
仍适用 Item 13:优先用 vector 和 string 代替动态数组
new T[n] 把长度、释放方式、异常清理和复制语义都交给调用者;vector<T> 把这些责任收进一个 RAII 对象,string 则进一步提供字符序列与结尾零字符的契约。二者都能给出连续存储,不需要为了传给指针接口而放弃拥有型容器。例外是 vector<bool>,它不提供普通 bool 数组,见 Item 18。
大小在编译期固定时用 array;接口只借用连续数据时用 C++20 的 span,只借用字符序列时用 C++17 的 string_view。视图不拥有元素,不能替代所有者,也不能让临时容器或已经扩容前的缓冲继续有效。确有不构造元素等底层存储需求时应单独论证,而不是把手工动态数组作为普通业务代码的默认方案。
1 | |
仍适用 Item 14:用 reserve 避免不必要的重分配
已知最终数量或可靠上界时,在批量追加之前一次 reserve,可以减少分配和已有元素的搬迁。对 vector,reserve(n) 只改变容量、不改变大小:预留后仍然必须 push_back、emplace_back 或 resize 来建立元素,不能直接写 v[0]。只有请求超过当前容量才重分配;成功后容量至少为请求值,而不是保证恰好等于它。
不要在每次追加之前调用 reserve(size() + 1):这样可能破坏实现的几何增长,把累计搬迁成本推向 。扩容会使全部元素引用、指针和迭代器失效;容量足够时尾部追加不使已有元素句柄失效,但旧 end() 仍失效,且中间插入有自己的失效规则。string::reserve 也用于规划增长,但不要把 vector 的全部失效保证照搬给它;C++20 起带参数的 string::reserve 不再承担旧标准中的缩容请求语义,释放多余容量应看 Item 17。
1 | |
需更新 Item 15:了解 string 实现的差异
原书讨论引用计数、写时复制(COW)和不同内部缓冲策略。C++11 之后的连续存储、访问复杂度与失效规则不再允许传统的 COW std::string 实现;不能再假定复制字符串只增加引用计数,第一次写入才付费。旧工具链 ABI 仍可能保留历史行为,但不能作为现代标准程序的依据。现代常见优化是小字符串优化(SSO),把较短内容存在对象内部;是否采用、阈值多少、sizeof(string) 多大,均不是标准保证。
可移植代码只依赖契约:字符连续,data()[size()] 是结尾零字符,复制后两份字符串的值可以独立修改。size() 是字符单元数量,不是 Unicode 字符数,也不等于 strlen(c_str())——字符串内部可以包含零字符。string 的移动也不能一概描述为“偷一个堆指针”,SSO 情形可能需要复制少量字符;不要据此推导对象移动后的缓冲地址。当前字符串存储要求明确区分了内容区间与结尾零字符。
1 | |
需更新 Item 16:正确把 vector 和 string 交给传统 C 接口
vector<T>::data() 从 C++11 起直接提供连续元素的指针,不必写空容器上非法的 &v[0]。空 vector 的 data() 不保证非空,接口必须按自身契约处理零长度。字符串只读零结尾接口用 c_str();C++11 起 string::data() 也有零结尾保证,C++17 起非 const string::data() 返回可写 char*。修改只能发生在已建立的内容区间内,不能把 reserve 出来的容量当作可写元素,也不能把结尾零字符改成非零值。
C 函数往缓冲写入时,先用 resize 建立足够的元素,传入与真实可写范围一致的长度,再按照函数报告的实际长度缩回;零结尾输出还要给终止符留位置,并按接口要求处理截断或失败。这里的 snprintf 接收当前 size(),故终止符也写在已建立的字符范围内。C++23 的 string::resize_and_overwrite 可减少某些输出缓冲的初始化成本,使用前检查 __cpp_lib_string_resize_and_overwrite >= 202110L,并遵守回调不能抛异常、返回长度不越界等契约。
传出去的指针只是借用:C 接口不得释放它,若接口保存地址供异步使用,必须保证所有者存活且期间不发生使地址失效的修改。用 qsort 这样的字节级搬移接口时还须满足元素可平凡复制等额外要求;不能因为 vector 连续,就拿 vector<string> 给它排序。下面仅对 int 使用该 C 接口。
1 | |
需更新 Item 17:理解交换技巧与容量收缩
删除元素、clear() 或缩小 resize() 不会让 vector 归还多余容量。C++11 增加的 shrink_to_fit() 是非强制请求,不保证实施收缩,更不保证 capacity() == size();发生重分配时全部元素句柄失效。string 也有这个请求,但内部布局和 SSO 可能让最终容量不同于大小。是否值得收缩应由后续是否还会增长、内存压力和搬迁成本决定,不要每次删除后都立即收缩。对 vector 的具体保证见容量操作要求。
原书的 swap trick 仍可用于重建缓冲后释放旧分配,但不能推广成任意分配器下的 Container(c).swap(c):复制构造可能选择不同分配器;当 propagate_on_container_swap 为假且两者分配器不相等时,交换违反前提。下面显式沿用原分配器构造紧凑副本,交换后让旧缓冲随局部对象析构;它需要元素可复制,而且新容量仍不保证恰好等于大小。若只想清空并结束这一批数据,优先结束所有者的作用域;使用 arena 时,容器释放分配也不意味着资源立即把内存还给系统。
1 | |
需更新 Item 18:谨慎使用 vector<bool>
vector<bool> 是允许位压缩的特殊化,不是普通的 vector<T> 实例:元素访问通常返回代理对象,而不是 bool&;它也不提供可交给 bool* 接口的普通连续数组。auto flag = bits[0] 可能保存的是仍引用原位的代理,后续赋值会修改容器;需要独立值时显式写 bool flag = bits[0]。代理仍依赖原存储,重分配后不能继续使用;泛型代码也不能假定解引用一定得到真实的 T&。
因此应把原书“避免”的建议理解为避免在需要普通引用、地址、连续存储或独立元素并发写入的接口中使用它,而不是断言位压缩没有价值。固定大小位集合可用 bitset<N>;动态、按字节存储的标志可用 vector<unsigned char> 等类型;确需动态位压缩则使用 vector<bool> 或专门位集合,并明确其代理与同步契约。C++23 扩展了代理赋值能力,改善部分输出迭代器场景,但没有把它变成连续的 bool 数组,也没有取消 Item 12 的并发例外。
1 | |
关联容器
仍适用 Item 19:理解相等与等价的区别
相等通常由 operator== 判断;有序关联容器里的等价由比较器决定:!comp(a, b) && !comp(b, a)。set / map 的唯一性、成员 find 和按键删除都使用后者,不要求两个键逐字段相等。只比较字符串长度的 set 会把 "cat" 与 "dog" 当作同一个键;而泛型 std::find 默认用 ==,两种查找的结果可以不同。这不是容器出错,而是接口选择了不同的关系。
设计键时先明确身份语义,再让排序、去重和查找保持一致。unordered_* 不通过排序定义等价,而使用 key_equal;它与哈希函数的配合见 Item 25。C++20 的 <=> 也不会把这些关系自动统一:比较器仍是有序容器的实际契约。
1 | |
仍适用 Item 20:为指针关联容器明确比较类型
std::set<T*> 默认使用 std::less<T*>,比较的是指针地址,不是 *p 的内容;标准库为这里的指针比较提供严格全序,不必自己对无关对象的指针写内建 <。如果需求是按对象内容排序,就显式提供解引用比较器。智能指针并不会自动改变这个选择:例如 shared_ptr 默认排序也不是对所指对象调用 <;所有权与键的比较关系是两件事。
解引用比较器的前提是指针非空、所指对象在容器使用期间始终存活,而且参与排序的内容不能被其他访问路径修改。需要允许空指针时,比较器必须先定义空值的位置,不能直接解引用。下面使用观察指针,字符串先于容器创建、晚于容器销毁,并且不可修改;内容相同的两个对象在地址集合里占两个位置,在内容集合里只占一个位置。
1 | |
仍适用 Item 21:比较函数对相同值必须返回 false
比较器描述“严格排在前面”,不是“不排在后面”:comp(x, x) 必须为 false,所以不能拿 <= 或 >= 当排序比较器。但这只是严格弱序的必要条件;比较关系还要具有传递性,由双向比较均为 false 定义的等价关系也必须具有传递性。随着时间变化的外部状态、循环排序规则,同样会破坏容器要求。违反这些语义约束不是可依赖的“特殊排序结果”。
浮点 NaN 是容易遗漏的边界:普通 < 让 NaN 与任意数都双向不可比较,然而 1.0 与 2.0 并不等价,于是等价关系失去传递性。键域若可能包含 NaN,就应拒绝它,或明确一个合法排序策略;下面让全部 NaN 等价并排在普通数之后,-0.0 与 +0.0 仍等价。它并非按浮点位模式区分每个 NaN 的全序,而是满足此处容器需求的严格弱序。
1 | |
需更新 Item 22:不要原地修改 set 和 multiset 的键
节点还在有序容器里时,改变参与比较的键会使实际位置与排序关系不符。set / multiset 的迭代器不给出可写的键,map / multimap 的元素则是 pair<const Key, T>;这些限制不能用 const_cast 绕过。map 的映射值 second 可以修改,前提是它确实不是键的一部分;指针所指对象和 mutable 字段也不能成为修改排序依据的后门。
C++17 的节点句柄提供了合法路径:先 extract,在节点脱离容器时改 set 节点的 value() 或 map 节点的 key(),再插入。唯一键容器发生冲突时,非提示版本 insert(node) 返回的 node 仍拥有未插入元素;忽略它会在句柄析构时销毁元素。下面把键 1 改为已有的 2,发现冲突后恢复原键并放回,两个元素都保留下来。跨容器转移还要求分配器兼容,不能把节点操作当成任意容器之间的搬运接口。
1 | |
需更新 Item 23:考虑用有序 vector 替代关联容器
批量构建、读多写少的数据适合“排序一次,二分查找多次”:vector 的连续存储减少节点和间接访问开销,查找需要 次比较。不过中间插入和删除要移动元素,成本为 ;迭代器和引用也不能享有节点容器的稳定性。比较器必须在排序、二分查找与去重之间一致;自定义比较时,unique 的谓词要采用比较器等价,而不一定是默认 ==。频繁增量修改、需要稳定引用或节点转移时,map / set 通常更合适。
C++23 把这个方向标准化为 std::flat_map / std::flat_set:前者默认用两个 vector 分别保存键和值,后者默认用一个 vector 保存键,提供有序查找和自动维护不变量的接口。它们不是所有操作都更快的 map / set:单次插入删除仍是线性的,迭代器失效规则取决于底层容器;flat_map 解引用得到的是键和值引用组成的代理,不能假定元素是连续的 pair 对象,更没有 Item 22 那种单节点接口。sorted_unique 标签只有在输入已按同一比较器排序且无等价重复时才能使用。
库支持不能仅看 -std=c++23:分别检查 __cpp_lib_flat_map >= 202207L 和 __cpp_lib_flat_set >= 202207L。下面保留不依赖它们的有序 vector 示例,支持相应库时再演示标准适配器;详细接口见 flat_map 与 flat_set。
1 | |
需更新 Item 24:重视效率时,仔细选择 map 的 operator[] 与 insert
先按语义选接口,再讨论构造次数。operator[] 是“访问或插入”:键不存在时插入一个值初始化的映射值,因此 m[key] = value 在缺键路径上通常是先构造再赋值,也不能用于 const map。只查询用 find,确定必须存在时用 at;需要缺键自动生成默认值的计数器则很适合 ++counts[key]。insert 是“只插入,不覆盖”,适合已经持有完整键值对的情况,必须检查它的插入结果。
C++17 提供更精确的选择:try_emplace(key, args...) 仅在缺键时构造映射值,键已存在时也不会移动传入的右值参数;insert_or_assign 则明确表达“新增或覆盖”,不要求映射类型能默认构造。但 try_emplace 不会延迟实参求值:try_emplace(key, make_value()) 即使撞键也会调用 make_value()。昂贵生成过程若必须只在缺键时执行,应显式先查找,接受额外查找成本,或者把便宜的构造参数交给 try_emplace;它不是懒求值工厂接口。相关语义见标准的 map 修改操作。
1 | |
需更新 Item 25:熟悉哈希容器——从非标准实现转向 unordered 容器
原书讨论的 hash_map / hash_set 是当年的非标准扩展;现代可移植接口是 C++11 的 unordered_map / unordered_set,以及允许重复键的两个 unordered_multi* 版本。它们不提供排序顺序,单键查找平均为 、最坏为 ;不能把迭代顺序用作持久化格式,也不能假定哈希表总比有序容器快。已知元素规模时提前 reserve,可以减少构建中的再哈希。
哈希与等价的契约是 key_equal(a, b) 为真时必须有 hash(a) == hash(b),反向不成立——不同键允许碰撞。只修改相等谓词却沿用不匹配的哈希会破坏查找前提;元素留在容器期间,键的哈希和等价结果也必须稳定。rehash 使迭代器失效,但不会使已有元素的指针和引用失效;删除对应元素才会使这些指针和引用失效。下面让身份只取决于 id,哈希也只处理 id,再用重新查找取得再哈希后的迭代器。
1 | |
迭代器
已过时 Item 26:优先使用 iterator 而不是其他迭代器类型
原书偏好 iterator 的主要原因是 C++98 容器修改接口对 const_iterator 支持不足,而不是只读迭代器本身不好。C++11 起,许多 insert / erase 的位置参数已经接受 const_iterator。现代选择应由权限和方向决定:只读访问用 cbegin / cend 或只读区间,需要改写元素时才用可写迭代器,逆向访问用反向迭代器,不应为了接口限制主动放宽权限。
const_iterator 限制通过它修改元素,不会把原容器变成 const:非 const 容器仍可用它定位并删除元素,erase 的返回值还可以是普通 iterator。反过来,const iterator 只是迭代器对象本身不能移动,不等于元素只读;而 set::iterator 即便名字没有 const,也不能修改键。
1 | |
已过时 Item 27:用 distance 和 advance 把 const_iterator 转成 iterator
旧办法是先计算 const_iterator 到起点的距离,再让普通 iterator 前进相同距离。它并不是强制类型转换,而是重新定位:对于 list 等非随机访问容器可能需要两次线性遍历,还要求容器未变且位置仍有效。现代 insert / erase 已能接受只读位置,没必要为这些操作转换;更不能用 const_cast 把真正 const 容器“变成可写”。
若确实需要通过位置改写元素,应在非 const 容器上重新获取可写迭代器,或重新设计查找接口,让它从一开始表达正确的访问权限。distance / advance 仍是计算距离和移动位置的有用工具,包括 C++20 的 ranges 版本;过时的是把它们当成修改成员函数的常规适配层。下面在只读位置前插入,并直接使用 insert 返回的可写迭代器。
1 | |
仍适用 Item 28:理解 reverse_iterator 的 base 迭代器
reverse_iterator 保存一个普通迭代器,但解引用时访问其前一个位置。因此对可解引用的 rit,*rit 对应 *std::prev(rit.base()),而不是 *rit.base();rbegin().base() == end(),rend().base() == begin()。这种错位让普通和反向的半开区间一致:反向区间 [rfirst, rlast) 对应普通区间 [rlast.base(), rfirst.base())。base() 是位置边界转换,不是“指向同一元素”的转换。
删除 rit 指向的元素应传 std::prev(rit.base()),并先排除 rit == rend()。继续逆向遍历时,把 erase 返回的普通后继重新包装为反向迭代器;不能继续使用已失效的旧 rit。C++14 的 std::make_reverse_iterator 能让这一步直接表达出来。插入则要先想清楚目标是普通顺序中的前面还是反向顺序中的前面,不能机械复用删除时的偏移公式。
1 | |
仍适用 Item 29:逐字符输入时考虑 istreambuf_iterator
istream_iterator<char> 使用格式化提取 operator>>,默认受 skipws 影响,跳过空格、制表符和换行;istreambuf_iterator<char> 直接从流缓冲区取得字符,不做格式化提取,也不因为 skipws 而丢空白。读取文本原貌时,后者语义更准确,还避开了逐字符格式化提取的工作;若确实需要格式化行为,前者才合适。std::noskipws 也能让格式化字符提取保留空白,但不因此变成缓冲区迭代器。
二者都是单遍输入迭代器,不能把副本当成独立游标来回遍历。缓冲区迭代器读的是流提供的 char,不是 Unicode 码点,也不会取消文件文本模式可能进行的换行转换;要保持文件字节,应同时选择正确的二进制打开方式。下面使用两个独立字符串流,把“格式化读取”与“保留全部字符”的差异直接断言出来。
1 | |
算法:输出空间、排序与删除
仍适用 Item 30:确保目标区间足够大
输出迭代器不一定会扩容。std::copy、transform 等算法写入目标位置时,普通迭代器要求那里已有对象;reserve 只准备存储容量,不增加 size(),因此不能对空 vector 的 begin() 写入。已有足够元素就直接写,需要追加则用 std::back_inserter;ranges 算法也不会自动替普通输出迭代器检查目标边界。
1 | |
仍适用 Item 31:了解不同的排序选择
先问结果需要满足什么性质,再选算法:全序用 sort,等价元素需保留原顺序用 stable_sort,只要最小的前 个且它们有序用 partial_sort,只要第 个位置及其两侧分区用 nth_element。nth_element 不保证两侧内部有序;partition 只按谓词分两组,不提供大小关系。list 没有随机访问迭代器,应使用成员 sort。C++20 ranges 版本可用投影,避免为每个字段重复写比较 lambda。
| 需求 | 算法 | 典型复杂度与边界 |
|---|---|---|
| 全部排序 | sort | ;不稳定 |
| 稳定的全部排序 | stable_sort | 有足够额外内存时 ,否则可达 |
| 最小的前 个有序 | partial_sort | 约 ;其余部分无序 |
| 第 个顺序统计量 | nth_element | 普通重载平均线性;两侧只是分区 |
| 按谓词分组 | partition / stable_partition | 前者线性且不稳定;后者稳定,但可能需要额外内存或更多交换 |
1 | |
比较器必须满足 Item 21 的严格弱序。不同算法的缓存行为、稳定性和额外存储需求不同,不能只根据渐进复杂度判断实际性能。
需更新 Item 32:remove 类算法之后还要 erase
std::remove / std::remove_if 只压缩区间,容器成员 erase 才改变大小。 算法只拿到迭代器,无法调用容器的删除接口;它把要保留的元素向前移动,保持它们的相对顺序,并返回“新的逻辑末尾” new_end。此时 [begin, new_end) 是保留区间,[new_end, end) 中的对象仍然存在,但值处于有效而未指定的状态,不能把这个尾部当作“被删元素的集合”。详见 std::remove 的语义。
1 | |
这就是 erase-remove 惯用法。按条件删除时换用 remove_if;std::unique 也只返回逻辑末尾,需要接 erase 才能缩短容器,而且它只合并相邻的重复元素。没有匹配项时,尾部是合法的空区间,不应改成单元素 erase(new_end)。
C++20 起,删除整个容器中的匹配元素优先用 std::erase / std::erase_if:前者按值,后者按谓词,返回值都是实际删除的元素个数。它们是非成员函数,对应重载声明在容器自己的头文件中;可用的容器和删除方式见 Item 9。
1 | |
std::ranges::remove / remove_if 并没有改变这条规则:C++20 的 ranges 版本返回待擦除尾部的 subrange,仍然需要成员 erase。它适合子区间操作或需要投影的场景,不是 std::erase 的同义替代:
1 | |
remove 不改变容器大小,但会给已有位置赋新值,位置有效不代表原元素身份不变。后续 vector::erase 使擦除起点及其后的迭代器、引用和指针失效,包括旧 end()。此外,比较目标不能借用待修改位置:std::remove(first, last, xs[0]) 和 std::erase(xs, xs[0]) 都可能在压缩时改写比较值。先用 auto value = xs[0]; 保存独立值,再删除;谓词捕获的比较目标也应保持稳定。
需更新 Item 33:警惕指针容器上的 remove 类算法
vector<T*> 删除的是指针值,不会替你 delete 指向的对象。若裸指针拥有对象,remove_if 的压缩可能覆盖待删除指针,丢失释放对象所需的地址;事后遍历 [new_end, end) 去 delete 也不正确,因为尾部不是被删除指针的可靠集合,还可能包含与保留区间相同的地址。现代解法是把独占所有权放进 std::unique_ptr,而不是给 erase-remove 补一段手动 delete。
1 | |
unique_ptr 的移动赋值和析构会自动释放被淘汰的对象,释放可能发生在压缩过程中,也可能发生在尾部擦除时,不应依赖“全部等到 erase 才析构”。若容器持有 shared_ptr,删除只是释放这一份强引用,其他拥有者仍在时对象不会析构;若裸指针只是观察者,则删除指针值即可,不应释放对象。
仍适用 Item 34:注意哪些算法要求有序区间
merge、includes 和 set_union 等集合算法要求各输入区间按所使用的比较关系有序;inplace_merge 要求相邻的两段各自有序,而不是整段已经有序。排序与后续操作必须使用一致的比较关系:降序排列的数据不能交给默认升序的二分查找。这里的“一致”指比较语义及其状态一致,不要求是同一个比较器对象;ranges 算法还要保持投影一致。集合算法也不是自动去重器:对重复元素,它们遵循相应的重数规则。
二分查找的前提比“全部排序”更精确:标准草案要求针对本次查找键分区。lower_bound 要求满足 comp(element, key) 的元素全部在前,不满足的全部在后;upper_bound 对 !comp(key, element) 要求相同的分区形态。binary_search 和 equal_range 需要两种分区,并要求比较关系相容。有序区间是对所有键满足这些前提的常见保证,但针对某个键分区并不意味着整体有序。partition 只保证谓词的真假分组,也不会替你建立任意键可用的排序关系。
1 | |
需更新 Item 35:用 mismatch 或 lexicographical_compare 实现简单的忽略大小写比较
原条款中的“简单”是关键限定。比较明确采用 ASCII 规则的协议字段时,可以逐字节折叠 A–Z,再用 lexicographical_compare 得到严格弱序;相同前缀时,较短字符串自然排在前面。只判断是否相等时,可以用带谓词的 equal,或用同时提供两个区间终点的 mismatch,检查两边是否同时结束;不要用只提供第二个起点的重载比较可能较短的第二个字符串。下面明确按 ASCII 字节值处理,非 ASCII 字节保持原值,不宣称支持自然语言文本。
若使用 <cctype> 的单参数 std::tolower、std::toupper 或字符分类函数,输入必须是 EOF 或可表示为 unsigned char 的值;普通 char 为有符号类型时,应先转换为 unsigned char。这是 C 字符函数的约束,不应机械套到 <locale> 的 std::tolower(c, loc) 模板上:把 unsigned char 传给后者会请求 ctype<unsigned char> facet,而该 facet 不保证存在。locale 方案要明确、固定所用 locale,并理解它的字符类型和编码能力;容器比较器存续期间也不能靠改变全局 locale 改变排序关系。
UTF-8 中一个字符可能占多个字节,Unicode 大小写折叠还可能把一个字符映射为多个字符;逐字节 tolower 无法完成它。需要 Unicode 忽略大小写的相等判断、规范化或语言相关排序时,应明确这些不同需求,并使用 ICU 等专门文本库,而不是把 ASCII 比较器扩充成一个貌似通用的方案。
1 | |
需更新 Item 36:理解 copy_if 的正确实现
C++98 没有标准 copy_if,原书因此解释如何正确补上这个算法;C++11 起直接使用 std::copy_if,C++20 起还有 std::ranges::copy_if,不再维护自己的同名替代实现。原来的机制仍值得理解:每个输入元素都推进输入迭代器,但只有谓词为真、实际写入元素时才推进输出迭代器;被选中的元素保持原来的相对顺序。不能让输出位置跟着每个输入元素一起前进,否则会留下空洞,甚至写出目标区间。
输出到空 vector 时使用 back_inserter,让每次输出赋值调用 push_back。若输出到普通迭代器,则必须已有足够多的元素;reserve 增加容量却不构造元素,不能据此向 begin() 后的未构造位置赋值。copy_if 的输入和输出区间也不能重叠。
1 | |
需更新 Item 37:用 accumulate 或 for_each 汇总区间
accumulate 的初值不仅决定从哪里开始,还决定累加器和返回值的类型。对 double 区间传入整数 0,会让每步结果回写到 int,不是最后赋给 double 就能恢复;应传入 0.0。整数求和也要按可能的总量选择 0LL 等初值,并确认该类型足以容纳结果。accumulate 按输入顺序左折叠,适用于依赖确定顺序的累加、字符串拼接等;需要维护多个统计量时,可以让累加器是一个小结构,也可以使用普通循环或有明确状态的 for_each。
C++17 的 reduce 和 transform_reduce 提供了允许重排、重新分组的归约模型,即使不传执行策略,也不能把它当作有固定顺序的 accumulate。希望结果不受这种自由影响,操作就需要具有相应的结合性、交换性;浮点加法、减法和字符串拼接不能一概满足。C++23 另有 ranges 折叠算法,例如 std::ranges::fold_left,使用前检查 __cpp_lib_ranges_fold >= 202207L;它解决区间接口和折叠表达的问题,不改变 reduce 的重排约定。
1 | |
函数对象与适配器
仍适用 Item 38:按值传递的方式设计函数对象
算法通常按值接收函数对象,内部也可能复制它;lambda 的闭包同样是对象,不会因为写法简短就自动按引用传递。函数对象应当小、容易复制,而且复制后仍表达同样的操作。不要指望对传入对象的内部状态所做的修改一定反映到原对象上,更不要通过传入派生类对象给按值接收基类的接口实现动态多态:那会发生切片。
确实要共享一个现存对象时,C++11 的 std::ref 或 std::cref 把它包装成可复制的引用句柄;它们既不拥有对象,也不延长生命周期。下面使用的是无执行策略的顺序 for_each,引用对象在整个调用期间存活。另一种可用方式是接收传统 std::for_each 返回的函数对象,读取其最终状态;这种明确的返回约定不能推广到所有算法。若改为并行算法,共享可变状态还必须另行解决同步问题。
1 | |
仍适用 Item 39:让谓词表现为纯函数
谓词应当根据输入和固定配置给出稳定结果,而不是根据“这是第几次调用”决定真假。算法可能复制谓词,某些算法也可能多次检查同一元素;即使知道谓词调用总次数,也不能据此假定副本之间共享计数或固定访问顺序。比较器更不能随调用改变排序关系,否则严格弱序的前提被破坏。按值捕获一个固定阈值完全合理,关键在于它在调用期间不变化,而不是禁止谓词具有任何成员。
C++20 的 std::predicate、regular_invocable 等 concepts 把这类要求纳入语义契约,但编译器通常只能检查表达式和类型,不能证明你的计数器或随机数是否改变结果。诊断、测量一类副作用也不应成为算法正确性的依赖。需要逐项更新统计、写日志等动作时,应使用 for_each 或显式循环,而不要把动作藏进一个决定筛选结果的谓词。
1 | |
已过时 Item 40:让函数对象能够被旧式适配器适配
原书所谓 adaptable functor,是提供 argument_type、result_type 或 first_argument_type、second_argument_type 等嵌套类型,让当年的绑定器、取反器能够理解函数签名。继承 std::unary_function、std::binary_function 是提供这些类型的常见手段;这两者以及 bind1st、bind2nd 在 C++11 弃用、C++17 移除。今天不应为了标准算法额外添加这一套 typedef,更不应重新实现这些旧适配器。
C++11 的 lambda 直接表达绑定参数和组合逻辑;std::bind 仍可用,但简单操作通常用 lambda 更容易看出捕获和参数关系。C++17 的 std::not_fn 可表达通用取反,C++20 的 ranges 投影则把“先选字段,再执行算法”直接放到接口中。下面按长度排序,不需要专门写一个携带旧式嵌套类型的比较类。
1 | |
已过时 Item 41:理解 ptr_fun、mem_fun 和 mem_fun_ref 的用途
这些设施解决的是两种旧问题:ptr_fun 给普通函数指针加上旧适配器所需的类型信息;mem_fun 和 mem_fun_ref 把成员函数指针变成可调用对象,分别适配对象指针和对象引用。它们均在 C++11 弃用、C++17 移除。今天普通函数或函数指针可以直接交给传统算法;成员函数调用通常用 lambda,或者 C++11 的 std::mem_fn,无需再按对象是指针还是引用选择两套包装。
C++17 的 std::invoke 提供统一调用规则,可处理普通可调用对象、成员函数指针和成员数据指针;C++20 的 ranges 算法按这些规则调用函数对象与投影,因此不少场景连包装都可以省去。std::mem_fn 仍然适合需要一个可保存、可传给传统算法的成员调用对象;它不是已移除的 mem_fun 的另一种拼写。旧设施的移除记录说明了这一迁移背景。
1 | |
仍适用 Item 42:不要让 less<T> 表达另一套排序关系
std::less<T> 的名称承诺了类型的通常小于关系。为自定义类型特化它、却悄悄改成“按名字”“按长度”等另一种顺序,会让显式使用 < 和默认关联容器比较器的代码产生不同含义。需要另一种排序时,应定义名字明确的比较器,并在容器或算法处显式指定;它同时决定有序关联容器中的等价关系,而不只是展示顺序。C++14 的透明比较器 std::less<> 也不是修改业务排序语义的入口。
这条建议不能误读为 std::less<T> 在所有类型上都只是机械执行内建 <:标准对指针比较器另有一致严格全序的保证,不能据此用裸指针 < 取代它。对于业务类型,保留通常关系与命名比较策略的区别即可。下面记录的自然顺序按编号,而容器显式按名字排序;名字相同的记录在这个 set 中属于同一等价类,若要同时保存它们,可使用 multiset 或加入编号作为次级排序键。
1 | |
STL 工程实践
仍适用 Item 43:优先使用算法调用,而不是手写循环
算法名称同时传达意图和边界:any_of 表达“是否存在”,transform 表达“逐项变换”,copy_if 表达“筛选并复制”。复用标准实现可以减少终点、递增、提前退出等细节错误,也给实现提供优化机会。C++11 的 lambda 和 C++20 的 ranges 进一步降低了把短操作交给算法的成本;原书时代为一个简单循环专门声明函数对象的负担已经小得多。
“优先”不是禁止循环,也不是算法必然更快。涉及多种状态协同、复杂提前退出、逐步错误处理,或为了套算法反而需要共享可变捕获和难懂组合时,普通循环可能更清楚。不要把每个循环都机械改成 for_each;关键是用更直接的结构描述真实操作。下面的 any_of 表达存在性,并在找到符合条件的元素后即可停止,无须为了得到一个布尔值遍历并计数整段。
1 | |
仍适用 Item 44:优先考虑与算法同名的容器成员函数
泛型算法只知道迭代器及其能力,成员函数则能利用容器内部结构。map::find 和 set::find 按键的比较等价性进行对数复杂度查找;泛型 find 按 == 线性扫描元素,两者既不一定比较同样的对象,也不一定采用同样的等价关系。map::lower_bound 能沿树结构查找,而把树迭代器交给 std::lower_bound 虽然比较次数仍为对数级,迭代器推进总量却是线性的;unordered 容器的成员 find 则具有平均常数、最坏线性的复杂度。
list::sort 也是结构差异,不是单纯“名字相同就快一点”:std::sort 要求随机访问迭代器,不能用于 list;链表成员排序是稳定排序,能通过重连节点完成,不要求把元素当作随机访问序列搬动。选择时仍需确认操作语义,不应仅凭同名无条件替换。下面同时使用链表排序和有序映射的成员查找,不重复删除类成员与算法的区别。
1 | |
需更新 Item 45:区分 count、find 和各类有序查找
先问需要什么结果,再看容器和已有不变量。无序的普通区间中,find 返回第一个相等元素的位置,找到即可停止;count 返回所有相等元素的数量,必须检查整段,不能为了判断存在就多做一次全量计数。有序区间里,binary_search 只回答是否存在比较等价的元素,lower_bound 返回第一个不小于键的位置,upper_bound 返回第一个大于键的位置,equal_range 返回整个等价区间。它们使用比较等价性,不是 ==;用 lower_bound 判断是否命中时,要检查终点,并依据同一比较器验证等价,而不是把插入位置直接当成命中。
关联容器应优先用成员 find、count、lower_bound 或 equal_range;C++20 的成员 contains 更直接表达键是否存在。C++23 的 std::ranges::contains 则是普通区间上的线性相等查找,不会因为名称一样就使用树、哈希表或二分搜索,使用前检查 __cpp_lib_ranges_contains >= 202207L。下面只用 C++20 已有设施:排序后的 vector 一次 equal_range 得到所有重复项,set::contains 则只检查是否包含键。
1 | |
仍适用 Item 46:考虑用函数对象而不是普通函数作为算法参数
当函数对象的具体类型及调用体对编译器可见时,算法模板的实例化更容易暴露内联和常量传播机会。C++11 起,lambda 通常是实现这一建议最简洁的方式;捕获的常量和对象类型都可以成为优化依据,也无需把一个只在此处使用的操作提升为全局函数。对于短小操作,通常没必要先包装成 std::function,再把类型擦除后的对象传给本来就接受具体类型的算法。
这只是优化机会,不是语言保证:函数对象的 operator() 不保证被内联,inline 关键字也不保证;已知目标的函数指针可能通过常量传播或链接时优化得到同样结果。选择 lambda、具名函数对象还是普通函数,先考虑接口和可读性;只有实际热点才需要结合优化选项、生成代码和代表性基准比较。不要把“函数对象通常便于优化”改写成“函数指针一定慢”。
1 | |
仍适用 Item 47:不要写只能写出、无法读懂的代码
复杂绑定器组合在现代代码中常被 ranges 管道取代,但“换成管道”并不自动等于可读。好的组合应当能按顺序读出筛选、变换和结果用途;复杂判断应提取成有意义的名字,而不是把捕获、条件表达式、类型转换全部塞进一行。一个读者需要反复展开模板和隐式状态才能理解的表达式,并不会因为没有显式循环就更高级。
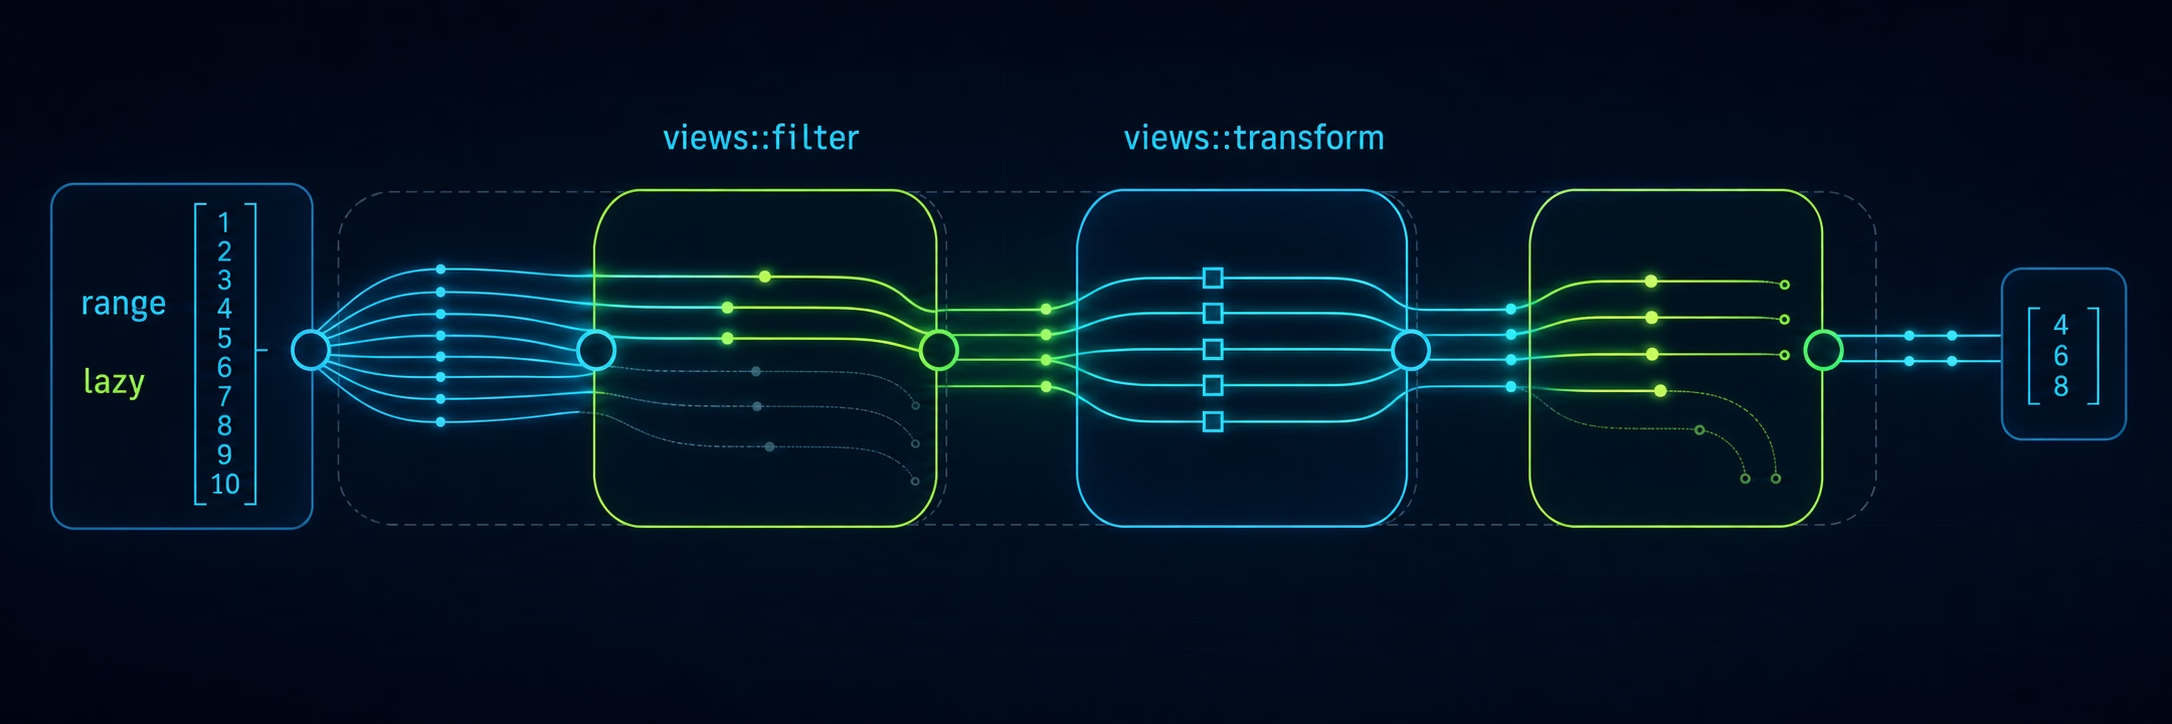
视图还引入了必须可见的生命周期边界:filter、transform 通常惰性求值,基于左值容器建立的视图通常借用源容器,捕获引用的回调也不会延长被引用对象的寿命。不要从函数返回借用其局部容器的视图;某些 ranges 算法对非借用临时区间返回 dangling,也不意味着所有视图链都自动安全。下面在参数仍存活时遍历管道,并返回拥有数据的 vector。C++23 可用 ranges::to 简化物化,但需要 __cpp_lib_ranges_to_container >= 202202L;此处的 copy 与插入迭代器在 C++20 即可使用。
1 | |
仍适用 Item 48:始终包含正确的头文件
直接使用哪个标准设施,就直接包含它所属的头文件。vector 不负责保证暴露 sort,algorithm 也不负责保证暴露 back_inserter 或 less;依赖某个版本的传递包含会让库升级、切换实现或调整其他 include 时无故破坏编译。常见对应关系是算法在 <algorithm>,数值归约在 <numeric>,迭代器适配器在 <iterator>,函数对象、引用包装和 invoke 在 <functional>,views 在 <ranges>。
ranges 算法仍在 <algorithm>,不能因为名称中有 ranges 就只包含 <ranges>。独立头文件也应自给自足,不让调用者通过 include 顺序补齐依赖。下面每个使用的设施都有直接来源;示例短不是省略正确 include 的理由。
1 | |
需更新 Item 49:学会解读 STL 相关的编译器诊断
不要从最长的一行模板展开开始读。先定位用户代码中的触发调用,再找最接近根因的错误或“不满足约束”说明,并把展开的类型还原成区间、迭代器、元素类型、比较器、投影和输出目标。对排序失败,优先检查是否随机访问、是否可修改、元素能否移动交换,以及比较器签名是否正确;对复制失败,检查输出是否可写、写入的类型能否赋值,而不是把标准库内部模板名称当作业务接口去修补。
C++20 concepts 和 ranges 能把部分错误提前到接口处,例如不满足 random_access_range、sortable 或 indirectly_writable。自己的泛型接口也应写出真实要求,让错误停在边界。concepts 仍不能替代语义检查:严格弱序、借用对象的寿命,以及某个初值是否符合数值需求,通常不是编译器能证明的性质。遇到噪声很大的诊断,应缩减成具有精确 include、完整输入类型和单次调用的最小示例,并确认所选标准版本和标准库实现。
1 | |
需更新 Item 50:熟悉 STL 相关的网站
原书列出的网站反映的是 2001 年的资料生态,今天不宜把那些链接当成持续维护的实现支持结论。应区分“标准规定什么”“参考手册怎样解释”“当前工具链实现了什么”三个问题:标准措辞决定前提、复杂度和失效规则;参考资料便于查接口、版本和示例;实现文档才说明具体版本的支持情况。
常用入口可以收敛到以下几类,而不是收藏大量内容重复、版本不明的教程:
- WG21 文档目录和标准工作草案的 HTML 展示用于查询正式提案和规范措辞。滚动草案可能已经包含 C++26 或更晚的变化,核对 C++11–C++23 行为时还要确认对应版本;已发布的 ISO 标准与滚动工作草案不是同一份文件。
- cppreference用于日常检索头文件、重载、引入与移除版本、失效规则和特性测试宏。它是高质量社区参考资料,不是 ISO 标准本身;其实现支持汇总也可能滞后于最新发布版本。
- libstdc++ 实现状态、libc++ 的 C++23 状态表和 MSVC STL 官方仓库用于核对库实现、缺陷与发布记录。还要确认页面描述的是主干还是已发布版本,并区分编译器的语言特性与所链接标准库的库特性。
因此,工程中不能仅凭 -std=c++23 或编译器版本号认定某个 C++23 库设施可用;应结合对应的 __cpp_lib_* 宏、目标标准库版本及发布文档。在线实验能帮助理解行为,但某个实现“碰巧可编译”不能替代对标准前提的判断。
现代检查清单
50 条可以压缩成以下工程检查点;具体接口是否合适,仍取决于所有权、迭代器类别、修改模式和性能测量。
| # | 规则 | 出处 |
|---|---|---|
| 1 | 默认考虑 vector,再按顺序、稳定句柄和修改模式选择其他容器 | Item 1、2、23 |
| 2 | 元素遵守值语义;资源用 RAII,独占所有权用 unique_ptr | Item 3、7、8、33 |
| 3 | 判空用 empty,批量操作优先区间接口 | Item 4、5 |
| 4 | 删除按容器选接口;remove 后接 erase,整容器删除优先 std::erase_if | Item 9、32 |
| 5 | 分配器和 pmr 资源必须覆盖容器的存活期;容量优化先测量 | Item 10、11、14、17 |
| 6 | 不把容器的线程安全等同于复合操作的原子性 | Item 12 |
| 7 | reserve 不是 resize;C 接口只访问有效元素,并遵守借用期 | Item 13、14、16、30 |
| 8 | string 连续存储有标准保证,SSO 与容量增长策略没有 | Item 15 |
| 9 | vector<bool> 有代理语义,不当作普通连续 bool 数组 | Item 18 |
| 10 | 区分相等与比较器等价;比较器满足严格弱序,哈希与相等保持一致 | Item 19–21、25、42 |
| 11 | 关联容器键要改就先 extract;插入冲突仍要保住节点 | Item 22 |
| 12 | 查询不误用 operator[];插入与更新分别评估 try_emplace、insert_or_assign | Item 24 |
| 13 | 只读遍历用 const_iterator;反向迭代器的 base() 指向后一个位置 | Item 26–28 |
| 14 | 全排序、前 k 个、顺序统计量分别选择对应算法 | Item 31 |
| 15 | 查找算法的分区或排序前提必须和实际比较器一致 | Item 34、44、45 |
| 16 | 文本比较先明确 ASCII、locale 或 Unicode 语义 | Item 29、35 |
| 17 | 用标准 copy_if;累加结果类型由初值决定,reduce 可重排计算 | Item 36、37 |
| 18 | 算法可复制函数对象,谓词结果不依赖副本或调用次序 | Item 38、39、46 |
| 19 | 旧适配器换为 lambda、invoke、mem_fn 或 ranges 投影 | Item 40、41 |
| 20 | 算法与循环按可读性选择;view 不延长数据或捕获对象的寿命 | Item 43、47 |
| 21 | 精确 include,先看约束诊断,再核对标准契约与实现支持 | Item 48–50 |
《Effective STL》留下的最重要习惯,是把“接口名字”与“操作契约”分开看:remove 不一定删除,reserve 不构造元素,less 不只是随便返回一个布尔值,find 也不总有相同复杂度。现代 C++ 把很多旧技巧变成了库接口,但正确使用它们仍要回答三个问题:谁拥有数据、哪些前置条件已经满足、操作之后哪些句柄还有效。