Rust 工程课程概览:从能运行到可维护
📚 Rust 课程系列
- 课程概览(本文)
- Rust 基础:变量、类型与转换的工程选择
- 字符串与切片:String、&str 与 UTF-8 边界
- 切片和范围:为函数设计稳定、低耦合的输入
- 表达式与控制流:让分支、循环和返回值清楚可审查
- 函数与 I/O:把所有权、错误和资源边界写进接口
- 所有权、借用与生命周期:用数据流理解编译器
- 结构体:组织数据、封装状态与编写方法
- 枚举:把状态、缺失和失败建模为类型
- 模式匹配:用穷尽分支处理业务状态
- 泛型与 trait:复用行为,同时保持接口清晰
- 集合:从访问模式选择 Vec、Map、Set 与队列
- 迭代器与闭包:让数据转换可组合
- 错误处理:区分可恢复失败与程序缺陷
- 模块:crate、路径与可见性
- 属性:让编译配置、诊断与文档可审查
- 宏:从声明宏到过程宏的边界
- 智能指针:让资源归属可组合
- 并发与异步:先划清所有权和取消边界
- Unsafe:把不安全性封装在最小边界
- Cargo 与依赖:建立可重复的 Rust 开发闭环
- Rust 工程实践:测试、性能与调试的优先级
这套课程解决一个具体问题:你已经具备基本编程概念,需要在几周内写出能构建、能测试、出错时能定位、评审时说得清理由的 Rust 代码,而不是背一遍语法清单。Rust 的门槛集中在所有权、借用与错误处理,这些约束无法靠"先跑起来再说"绕过去。因此每一章都把约束放进可运行的小程序里,让你在编译器与测试的反馈中建立直觉。
学习目标与前提
前提:你具备基本编程概念——变量、函数、条件、循环,以及至少一门主流语言的使用经验。不需要系统编程或 C++ 背景。
基线:当前稳定版 Rust 工具链 + Edition 2024。没有特别说明时,示例只依赖标准库;仅第 16、18、20、21 章会引入外部依赖,并给出完整的依赖声明与替代方案。
学完 21 章后,你应该能:
- 用 Cargo 从零创建、构建、测试并运行一个小型任务队列 CLI;
- 让
cargo check、cargo test、cargo fmt --check、cargo clippy全绿,并说出每条命令各自证明什么; - 面对借用检查器的报错,从第一条错误读起,定位到数据流层面的原因;
- 评审他人代码时,围绕所有权、失败路径和模块边界提出具体意见;
- 全程不绕过所有权与错误边界:不用
clone压制借用报错,不用unwrap吞掉可预期失败。
课程地图:四个阶段,21 章
课程的业务语境统一是一个任务队列 CLI:每章的示例都在这个领域里重新定义所需的类型,彼此连续但不要求拼装成一个应用。
阶段一:语法与 I/O(第 1–5 章)
| 章 | 完成后你能做到 |
|---|---|
| 第 1 章:Rust 基础:变量、类型与转换的工程选择 | 用正确的绑定、类型标注与受检转换写出可读的小函数 |
| 第 2 章:字符串与切片:String、&str 与 UTF-8 边界 | 在 String 与 &str 之间做正确的所有权选择,安全处理 UTF-8 字符边界 |
| 第 3 章:切片和范围:为函数设计稳定、低耦合的输入 | 用 &[T] / &str 设计不绑定具体容器的函数输入,掌握 Range 家族的类型、迭代能力与含端点坑,安全处理越界 |
| 第 4 章:表达式与控制流:让分支、循环和返回值清楚可审查 | 让 if、match、循环产生类型明确的值,失败路径一眼可审查 |
| 第 5 章:函数与 I/O:把所有权、错误和资源边界写进接口 | 把所有权、错误与文件 I/O 边界写进函数签名,用 ? 组织失败路径 |
阶段二:所有权与数据建模(第 6–9 章)
| 章 | 完成后你能做到 |
|---|---|
| 第 6 章:所有权、借用与生命周期:用数据流理解编译器 | 用数据流理解 move、借用与生命周期,读懂借用检查器的报错 |
| 第 7 章:结构体:组织数据、封装状态与编写方法 | 用结构体与 newtype 组织数据、封装不变量、编写方法 |
| 第 8 章:枚举:把状态、缺失和失败建模为类型 | 用枚举把互斥状态、缺失与失败建模为类型,非法组合无法构造 |
| 第 9 章:模式匹配:用穷尽分支处理业务状态 | 用穷尽的模式匹配处理每个业务状态,新增变体时强制复核所有处理点 |
阶段三:可复用项目边界(第 10–16 章)
| 章 | 完成后你能做到 |
|---|---|
| 第 10 章:泛型与 trait:复用行为,同时保持接口清晰 | 用泛型与 trait 复用行为,区分静态与动态分发的代价 |
| 第 11 章:集合:从访问模式选择 Vec、Map、Set 与队列 | 从访问模式出发选择 Vec、Map、Set 与队列,而不是凭感觉 |
| 第 12 章:迭代器与闭包:让数据转换可组合 | 用迭代器管道与闭包组合惰性数据转换,写清借用与生命周期边界 |
| 第 13 章:错误处理:区分可恢复失败与程序缺陷 | 区分可恢复失败与程序缺陷,设计调用方可分支处理的错误类型 |
| 第 14 章:模块:crate、路径与可见性 | 用模块、路径和可见性设计可重构的 crate 边界 |
| 第 15 章:属性:让编译配置、诊断与文档可审查 | 用属性表达条件编译、trait 语义、诊断与文档规则 |
| 第 16 章:宏:从声明宏到过程宏的边界 | 在函数、声明宏和过程宏之间做可维护的选择 |
阶段四:资源与生产工作流(第 17–21 章)
| 章 | 完成后你能做到 |
|---|---|
| 第 17 章:智能指针:让资源归属可组合 | 按所有权、线程可用性与运行期借用三个维度为数据选择智能指针 |
| 第 18 章:并发与异步:先划清所有权和取消边界 | 在线程与异步任务里先划清所有权与取消边界 |
| 第 19 章:Unsafe:把不安全性封装在最小边界 | 把 unsafe 封装在最小、可审查的边界内,说明 Send、Sync 等 trait 合同的安全含义 |
| 第 20 章:Cargo 与依赖:建立可重复的 Rust 开发闭环 | 用 Cargo 建立可重复的构建、测试、文档与依赖维护闭环 |
| 第 21 章:Rust 工程实践:测试、性能与调试的优先级 | 按优先级组织测试、性能与调试工作:先正确,再测量,再优化 |
初始化与质量循环
每章的主示例都假定你在这样一个项目里运行它。整个循环可以复制执行:
1 | |
每条命令各自证明一件事:
| 命令 | 证明什么 |
|---|---|
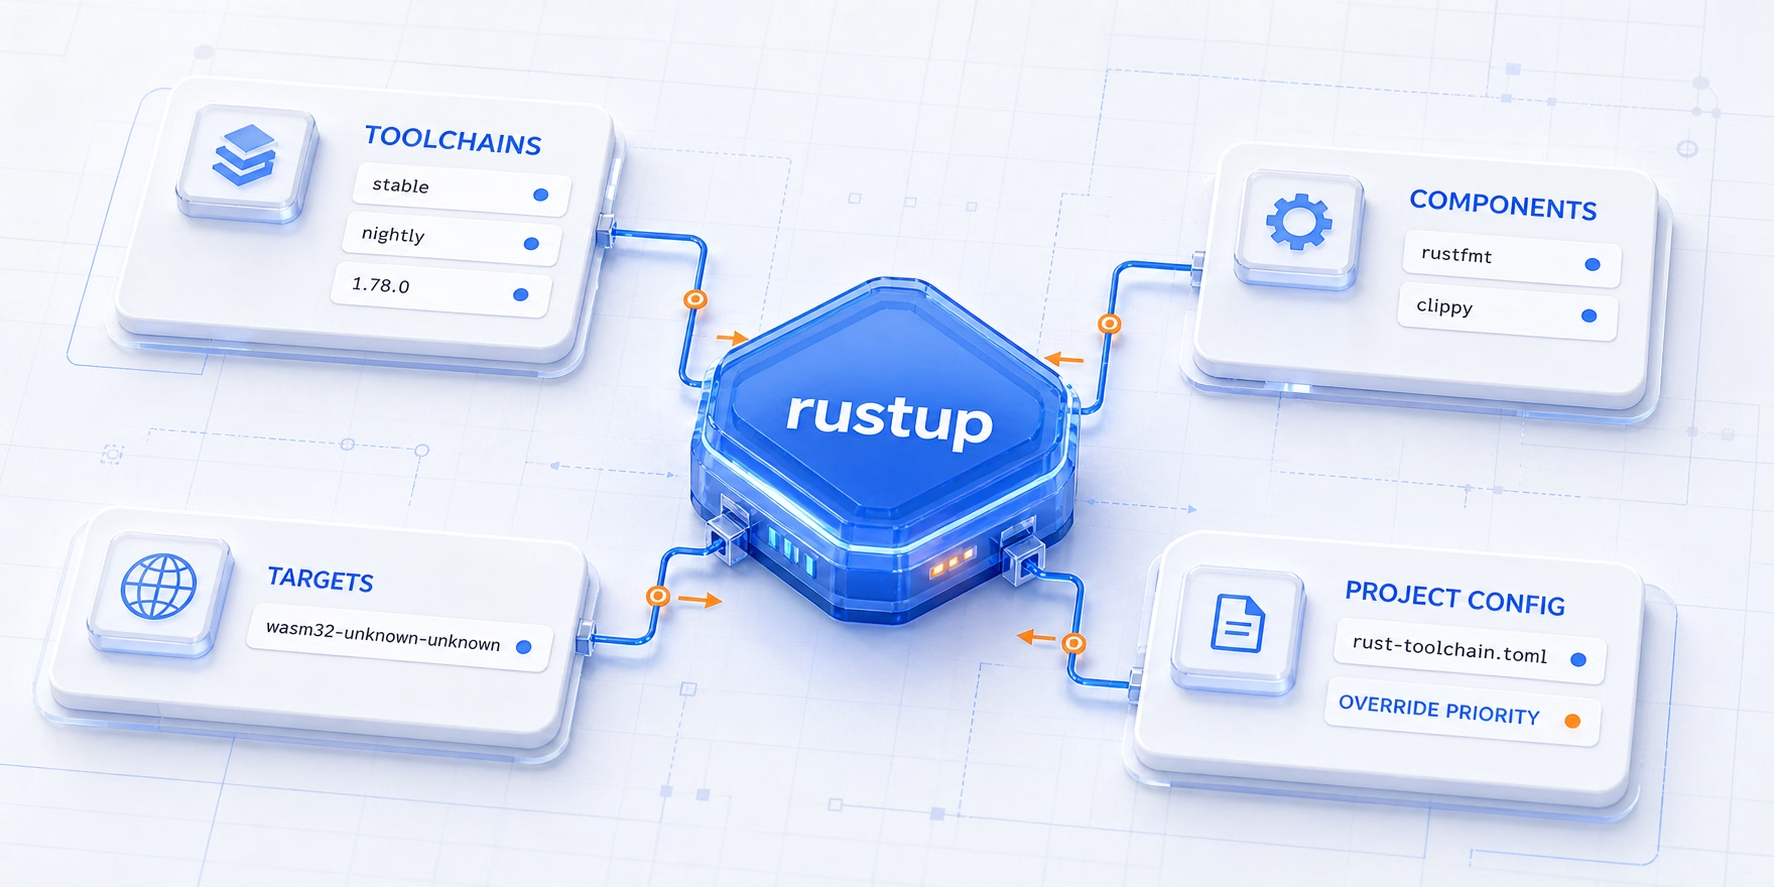
rustup default stable | 固定使用稳定工具链;课程示例全部以稳定版为准,不需要 nightly |
cargo new --bin --edition 2024 task_cli | 创建一个 Edition 2024 的可执行项目,起点可重复 |
cargo check | 类型检查与借用检查通过——"编译器认可的约束"成立;不做代码生成,速度快,适合高频反馈 |
cargo test | 断言真的通过了——逻辑正确性必须靠可执行测试证明,check 证明不了这一点 |
cargo fmt --check | 格式与标准一致,评审不再花时间在排版上 |
cargo clippy --all-targets -- -D warnings | 含测试代码在内的惯用法问题被当作错误拦下 |
特别区分前两条核心命令:cargo check 通过只说明"类型与借用没有违规",一个逻辑完全错误的程序也能通过 check;cargo test 会编译并真正运行测试函数,断言失败会红。写示例时的习惯应该是:先用 check 快速迭代到编译通过,再用 test/run 验证行为。第 20 章会把这套循环扩展到工作空间与依赖,第 21 章扩展到调试与基准测试。
读者工作流
每章按同一个节奏使用:
- 运行每个主示例:
cargo new --bin --edition 2024 scratch-N,把示例完整复制进src/main.rs,cargo run。示例都自带断言,输出干净即通过。 - 改一个断言的输入:比如把端口从
"8080"改成"99999",先预测结果,再运行验证。预测错的那次就是你要补的概念。 - 完整读第一个编译器错误:从错误码和位置读到最后的 help 行,再动手改。Rust 的错误信息是按"先看第一条"设计的。
- 做章末自测:答不出的题回到对应小节重读,再进入下一章。所有权(第 6 章)之前不要跳章。
读示例代码时先问四个问题:
- 这个值由谁拥有,何时释放?
- 这里是借用、修改,还是转移所有权?
- 失败或缺失是如何表达并传播的?
- 模块边界是否只暴露调用方真正需要的能力?
能持续回答这四个问题,就抓住了 Rust 工程代码大部分的可读性。
工程中的默认选择
课程反复回到这张表。它们不是绝对规则,而是安全起点;每条约束都在对应章节展开论证:
| 问题 | 优先选择 | 约束在哪一章确立 |
|---|---|---|
| 只读一段数据 | &str、&[T] | 第 3 章 |
| 可能失败 | Result<T, E> + ? | 第 4、5 章;错误类型设计见第 13 章 |
| 可能没有值 | Option<T> | 第 1、4 章 |
| 业务状态互斥 | enum | 第 8、9 章 |
| 共享跨线程状态 | Arc<Mutex<T>> 或消息通道 | 第 18 章 |
| 容器不确定 | 先用 Vec / HashMap | 第 11 章 |
先把程序写正确、边界表达清楚,再根据测量结果优化(第 21 章)。优化、unsafe、动态分发、外部 crate 在本课程中都不是默认选项,每次出现都会说明代价与替代方案。
为什么可行:把约束前移到编译期
这套循环有效的根本原因是约束前移:所有权、借用、类型穷尽性检查发生在编译期,反馈以秒计;断言发生在测试期,反馈以分钟计。两者都比"评审发现"或"生产事故"便宜一个数量级以上。默认选择表之所以是安全起点,是因为每一条都把一类运行时错误(悬空引用、空指针、非法状态组合、未处理的失败)变成了编译期错误。当你觉得编译器在碍事时,正确的问法是"它在阻止哪一类缺陷",而不是"怎么让它闭嘴"。
常见误区
- 把 Rust 当"更严格的旧语言":用
clone和unwrap把旧习惯硬搬过来,约束没有消失,只是推迟到生产环境兑现。 - 跳章:没过所有权(第 6 章)就直接学并发(第 18 章),几乎必然停留在复制粘贴示例的阶段。
- 只读不跑:Rust 的肌肉记忆来自"修改—编译—读错误"的循环,读十遍不如跑一遍、改一遍。
- 过早依赖外部 crate:标准库能解决的问题先查标准库;依赖的维护成本在第 20 章量化。
- 追求单行紧凑:
if/match产生值不是为了写密集代码,是为了让每个分支的类型可审查。
自测
cargo check通过能否说明程序逻辑正确?——答方向:不能;check 只做类型与借用检查,逻辑要靠cargo test运行断言证明。- 课程的工具链与 Edition 基线是什么?——答方向:稳定工具链 + Edition 2024;示例默认只用标准库。
- 遇到编译错误的第一步是什么?——答方向:完整读完第一条错误(错误码、位置、帮助行),再改代码。
- "只读一段数据"的默认接口选择是什么,为什么?——答方向:
&str/&[T];不转移所有权、不强制分配,接口不绑定具体容器(第 3 章)。 - 四个阶段分别解决什么问题?–答方向:语法与 I/O(1–5)-> 所有权与数据建模(6–9)-> 可复用项目边界(10–14)-> 资源与生产工作流(15–19)。