Go 的 iter:从 range 函数到可组合迭代
Go 1.23 为 for range 增加了函数作为遍历对象的能力,同时引入标准库包 iter。这不是为 Go 补上 Java、C++ 风格的可变游标对象,而是把已有的回调遍历模式标准化为可组合的序列协议:生产者调用 yield 推送元素,消费者通过 range 决定是否继续。
本文的代码要求 Go 1.23 或更新版本。语言特性是“对函数 range”,
iter包则提供了通用命名类型和按需拉取适配器。
为什么需要 iter
Go 在 1.23 之前已经能遍历内建集合:切片、数组、字符串、映射和通道。但自定义集合只能自行选择 API:有的返回切片,有的接受回调,有的暴露 Next() (T, bool)。返回切片会提前分配并装载全部结果;自定义游标又难以与其他库组合。
iter 统一的是“序列”的边界,而不是底层容器。树、数据库结果、目录、分页接口、流式解析器都可以暴露同一种返回类型,调用方仍然写熟悉的 for range。
它采用推送(push)模型。序列拥有推进权,依次调用消费者给它的 yield 函数;yield 的布尔返回值是反压和提前终止信号。相比把元素先放进 channel,这个模型不固有地引入 goroutine、同步或缓冲。
核心类型与协议
iter 的全部基础抽象只有两个具名函数类型:
1 | |
Seq[V] 每次产生一个值;Seq2[K, V] 每次产生一对值,惯例是键值或索引值。它们并非接口,没有 Next 方法,也不保存隐式游标状态。
一个最小的生产者如下:
1 | |
消费端直接 range:
1 | |
这里输出 1 和 2。break 会令编译器生成的 yield 返回 false,因此 CountTo 必须立刻返回。忽略该返回值是实现迭代器最常见、也最严重的错误:循环体已经离开后继续调用 yield 会触发运行时 panic。
for range 支持的函数形状只有三种,参数个数决定循环变量个数:
1 | |
零值形式适合只表示“发生一次”的序列,实际业务通常使用后两种。函数必须恰好接受一个 yield 参数,yield 必须返回 bool;其他函数即使看起来相近,也不能成为 range 的对象。
range 函数如何工作
下面的代码是理解机制的关键:
1 | |
可以将它理解为下面的概念性改写,而非要求编译器生成完全相同的源码:
1 | |
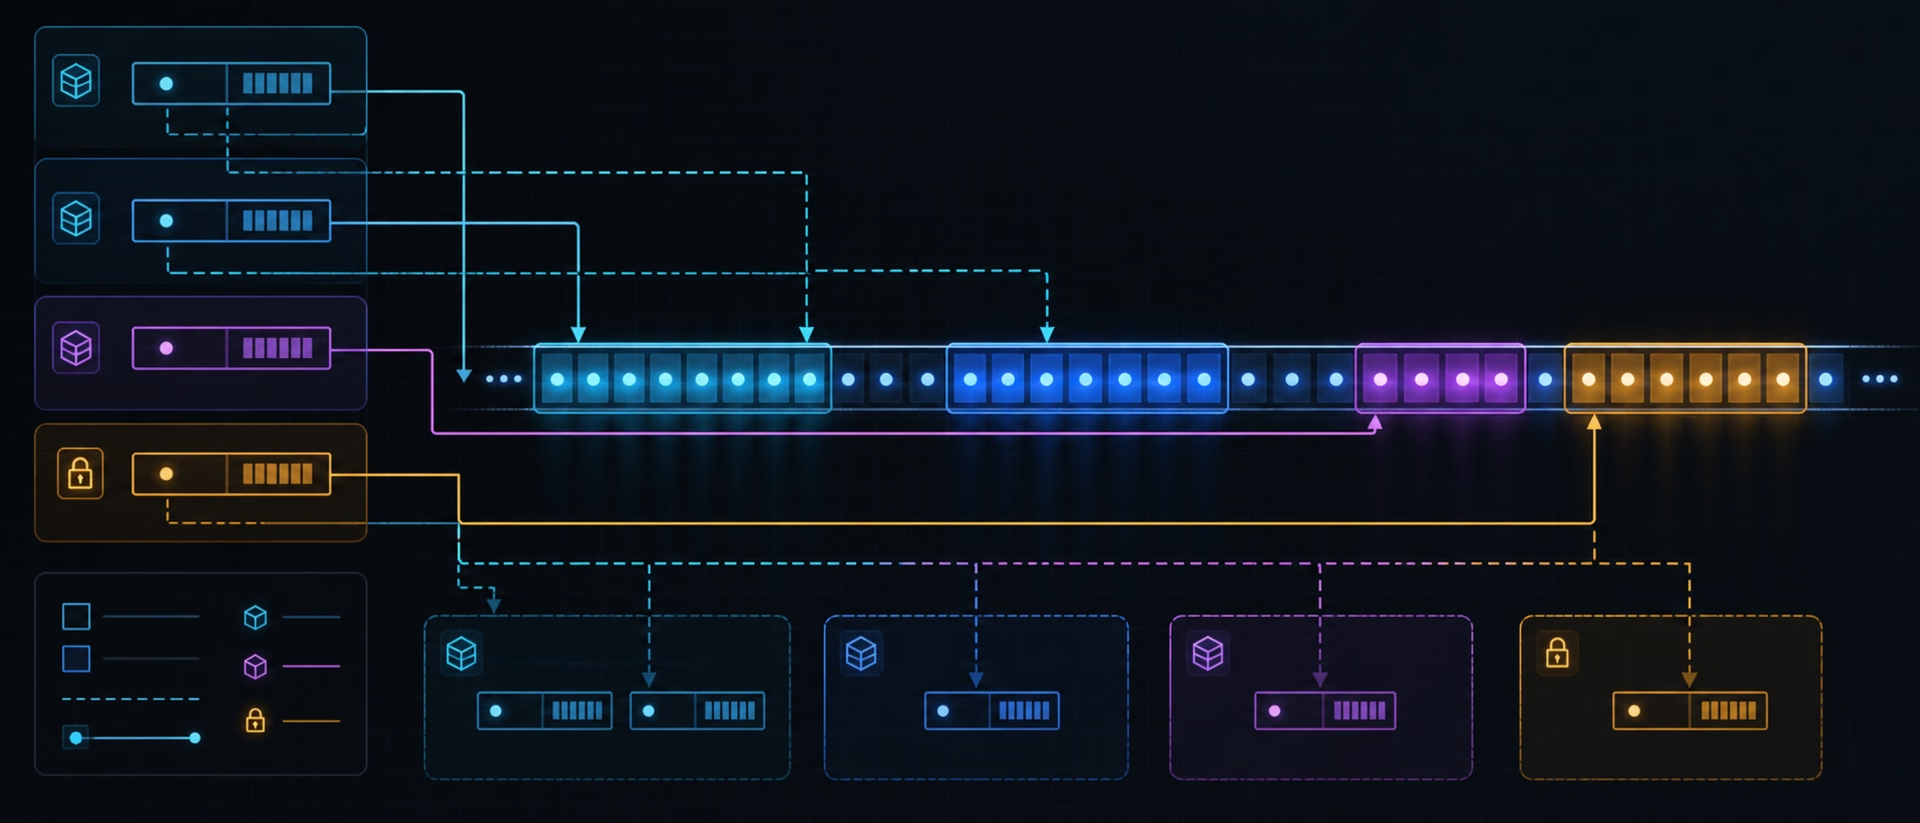
生产者调用 yield(v) 时,控制权同步进入循环体;循环体结束后,再通过布尔值把控制权交还生产者。因此一次 yield 同时完成“交付元素”和“询问是否继续”:
| 循环体控制流 | yield 的结果 | 生产者动作 |
|---|---|---|
正常结束或 continue | true | 计算下一个元素 |
break | false | 立即结束并清理 |
return | false | 先让迭代器返回,再从外层函数返回 |
panic | 不返回 | panic 沿调用栈传播 |
这解释了两个约束。第一,生产者应在自己的调用栈中同步调用 yield,不能保存它以后再用,也不应把它交给其他 goroutine。第二,收到 false 后必须停止,不能再调用 yield。这让 break、return、defer 和 panic 都维持普通函数调用的语义。
range 不会自动把惰性计算变成并发计算。CountTo 中的下一次循环仅在上一轮循环体完成后执行;对只在需要时读取文件、遍历树或请求下一页尤其有用。
为自己的类型设计迭代器
自定义集合应返回 iter.Seq 或 iter.Seq2,而不是返回匿名但等价的函数类型。具名类型能让 API 与 maps、slices 及其他适配器直接互通。
以下集合为每次调用 All 创建一次新的遍历:
1 | |
调用方获得了表示无序性的普通 Go 映射语义:
1 | |
命名应描述产生的序列。集合完整遍历通常命名为 All;多个顺序可用 Backward、Preorder 等名字区分;带边界的扫描可以命名为 Scan(min, max)。若序列只能遍历一次,例如包装网络流或 bufio.Scanner,文档必须明确标注“single-use iterator”,并说明提前停止后再次调用的行为。
迭代器内的资源应使用 defer 管理。消费者提前 break 时,yield 返回 false,生产者函数正常返回,因而其 defer 仍会执行:
1 | |
不要在元素上隐式塞入修改能力。若遍历期间需要删除或更新,应返回显式的临时位置对象,例如 iter.Seq[*Position],并清楚规定该位置对象只在对应的 yield 调用期间有效。
编写可组合的适配器
迭代器的价值在于不物化中间切片也能组合。过滤器只需把上游的停止信号逐层原样返回:
1 | |
for v := range seq 本身已经负责把本层的 break 传回上游;本层只有在实际调用 yield 后才需要检查其结果。由此可以组成按需执行的管道:
1 | |
此例只会计算到第一个满足 isPrime 的值。若把 Filter 写成先收集到 []V 再返回,提前退出和惰性的收益都会丢失。
错误通常使用 Seq2[T, error] 传递;错误是序列中的最后一项,产生后立即结束:
1 | |
如果底层 API 能区分“正常结束”和“错误结束”,这个约定避免丢失流式特性。生产者在最后一次 yield("", err) 后不应继续产生值;消费者收到错误也应结束消费。
标准库中的组合
Go 1.23 起,maps 与 slices 已采用这套协议。常用函数包括:
| 目标 | 函数 | 结果 |
|---|---|---|
| 遍历映射 | maps.All(m) | iter.Seq2[K, V] |
| 获取映射键或值 | maps.Keys(m)、maps.Values(m) | iter.Seq[K]、iter.Seq[V] |
| 遍历切片 | slices.All(s) | iter.Seq2[int, E] |
| 反向遍历切片 | slices.Backward(s) | iter.Seq2[int, E] |
| 逐值遍历切片 | slices.Values(s) | iter.Seq[E] |
| 收集结果 | slices.Collect(seq) | []E |
| 追加结果 | slices.AppendSeq(dst, seq) | 扩展后的切片 |
| 排序并收集 | slices.Sorted(seq) | 已排序的 []E |
例如,按键排序后处理映射,排序是明确的物化边界:
1 | |
maps.Keys 仍继承映射的随机遍历顺序;只有 slices.Sorted 收集并排序后才获得稳定顺序。是否物化应由业务语义决定,而不是因为迭代器 API 让代码看起来更“函数式”。
Pull:何时需要逐项拉取
绝大多数场景应该直接 range。当算法必须在两个序列之间交替读取、需要预读一个元素,或要把推送式序列接到旧的 Next 风格接口时,使用 iter.Pull 或 iter.Pull2:
1 | |
next 在结束后持续返回零值和 false;stop 可重复调用。若没有读到结尾,必须调用 stop,通常立即 defer stop()。next 与 stop 不可被多个 goroutine 并发调用。
实现上,Pull 使用运行时 coroutine 在生产者与消费者之间切换:生产者到达 yield 时交出值并暂停,next 再次调用时恢复生产者。它不是用 channel 加 goroutine 模拟,因此避免了那套生命周期管理;但仍有状态维护和协程切换成本。直接 range 是同步回调路径,通常更简单,也更容易被编译器内联优化。
性能与边界
iter 不是“必然零分配”的承诺。闭包捕获、逃逸、适配器层数和被调用函数是否可内联都由具体代码与编译器决定。它保证的是按需传递元素的控制流,不保证所有实现都没有分配。
选择 API 时可遵循以下规则:
- 结果必须随机访问、重复使用或需要整体排序时,返回或收集为切片。
- 结果很大、可提前停止或天然流式时,返回
iter.Seq。 - 只在交替消费等确实需要拉取的算法中使用
iter.Pull。 - 生产者必须尊重
yield == false,消费者不要跨 goroutine 并发驱动同一个Pull。 - 对可重试、可重复遍历的容器,让每次调用序列都从头开始;做不到时在文档中声明单次使用语义。
可以用逃逸分析验证具体热路径,而不是猜测:
1 | |
随后用基准测试比较完整遍历和提前退出两种负载。迭代器常在后者表现出优势,但对很小的固定切片,直接索引循环往往仍是最清晰的选择。
小结
iter.Seq 把“调用 yield,并尊重其布尔结果”变成 Go 生态统一的序列契约;对函数 range 让这个契约保持普通 for range 的可读性。它适合惰性、可提前停止且需要组合的遍历,不替代所有切片和状态机。先以同步 push 序列建模,只有在算法确实需要逐项控制时才转换为 Pull。
参考资料