gperf-usage
在词法分析器、配置解析器或固定命令分发中,经常需要把字符串映射为枚举。词表在编译时已经确定、运行时只查询时,可以让 GNU gperf 在构建阶段生成专用的 C++ 查找代码,再把它编译进程序。运行时不需要安装 gperf,也不需要链接 -lgperf。GNU gperf 官方介绍
本文用 if、else、for、while、return 五个关键字搭建完整示例:编写词表,生成代码,封装 std::string_view 接口,再接入 CMake 自动生成。示例使用 C++23,实际只依赖 C++17 已提供的 std::optional 和 std::string_view。
1. 什么时候适合使用 gperf
先判断词表是否固定,以及查找是否值得优化:
| 场景 | 建议 | 原因 |
|---|---|---|
| 只有几个分支,性能没有压力 | 直接比较字符串 | 代码最容易维护 |
| 编译时固定的关键字集合,查询频繁 | 考虑 gperf | 可生成专门的静态查找结构 |
| 运行时注册、删除命令 | std::unordered_map | 需要动态更新集合 |
| 固定集合,优先减少构建工具依赖 | 数组配合线性或二分查找 | 无需代码生成步骤 |
这里使用五个关键字是为了演示流程,不能据此推断 gperf 比几个 if 更快。工程中应先测量真实输入,再决定是否增加生成步骤。
原理:完美哈希不等于无需比较字符串
gperf 针对给定关键字集合寻找哈希函数,让集合内不同关键字得到不同哈希值。查询通常先检查长度,再计算哈希值、取出候选项,最后比较实际内容。
无冲突的保证只针对预设集合。 任意非关键字仍可能落入某个关键字的槽位,因此不能把“哈希命中”直接当成“字符串命中”。本例五个关键字的长度恰好不同,gperf 3.3 生成的哈希函数只需使用长度;zz 与 if 长度相同,仍必须靠内容比较排除。
完美哈希也不一定是最小完美哈希:生成表可以包含空槽。把表强行缩到关键字数量并不一定更快,空间和查询成本需要一起衡量。官方手册:静态查找结构
2. 准备工具
需要 C++ 编译器和 gperf 3.1 或更新版本。接入自动生成时,还需要 CMake 3.20 或更新版本。
macOS 可以通过 Homebrew 安装:
1 | |
安装方式见 Homebrew 的 gperf 页面。Debian / Ubuntu 可以使用:
1 | |
确认当前实际使用的版本:
1 | |
注意 macOS 的 /usr/bin/gperf 可能是旧版本。本地验证时该路径提供的是 3.0.3,它会在生成代码中使用 register,导致现代 Clang 在 C++17 及更新标准下编译失败。若安装了新版仍报错,检查 PATH 和 CMake 缓存中的 GPERF_EXECUTABLE,确保调用的是新版程序。
3. 从词表生成 C++ 查找器
创建以下目录,并在 gperf-demo/ 中执行后续命令:
1 | |
CMakeLists.txt 和 tests.cpp 分别在后面的章节补充。build/keywords.inc 是生成物,其他文件由我们维护;.inc 只是表示“供实现文件包含”,它的内容仍是普通 C++ 代码。
3.1 定义业务接口:keywords.hpp
公开接口只暴露业务枚举和解析函数:
1 | |
parse_keyword() 返回 std::optional<Keyword>:命中时返回对应枚举,未命中时返回 std::nullopt。Unknown 用于生成表的空槽初始化,不是这个接口的失败返回值。
3.2 定义词表:keywords.gperf
1 | |
输入文件分为三个部分:第一个 %% 前是声明区,中间是关键字及附加字段,第二个 %% 后可以追加实现代码;本例最后一部分为空。
%{与%}之间的代码会原样写入输出,本例用它包含业务头文件。%struct-type指定每个表项使用KeywordEntry。本例第一个字段必须是字符串字段name,类型为const char*;后面的字段可以携带枚举、编号等业务数据。- 词表每行第一个字段是被匹配的字符串,其余字段作为 C++ 初始化表达式写入生成代码。
demo::Keyword::If对 gperf 来说只是要输出的文本,它不会检查这个枚举是否存在。
核心声明的作用如下:
| 声明 | 作用 |
|---|---|
%language=C++ | 生成 C++ 类及其成员函数 |
%define class-name KeywordHash | 指定生成类的名称 |
%define lookup-function-name lookup | 指定查询函数名称 |
%readonly-tables | 把生成表声明为只读 |
%compare-lengths | 比较长度并使用二进制内容比较 |
%compare-strncmp | 单独使用时启用有界字符串比较 |
%includes | 生成所需的 <string.h> 包含语句 |
%enum | 用局部枚举保存生成常量,减少宏污染 |
%define initializer-suffix ,demo::Keyword::Unknown | 为表的空槽补齐附加字段初始化 |
initializer-suffix 的值以逗号开头,直接连接在空槽的字符串字段后面。本例写成一个不含空格的值;不要随意添加引号或把字段拆成多个参数。官方手册:输入声明
3.3 生成实现
1 | |
生成文件会包含 KeywordEntry、KeywordHash 和静态查找表。lookup() 的接口形态为:
1 | |
命中时返回静态表项指针,未命中时返回 nullptr。该指针是借用,不能 delete,也不应修改表项。业务代码通常只需要取出枚举,不必把生成表项类型暴露出去。官方手册:输出格式
3.4 封装生成代码:keywords.cpp
1 | |
这样做有三个好处:调用方不依赖生成类的名称;生成实现只进入一个翻译单元;未命中的处理集中在一个入口。
keywords.inc 已经被 keywords.cpp 包含,不要再把它作为独立 C++ 源文件编译,也不要让多个 .cpp 同时包含它,否则可能产生重复定义。生成文件也不适合直接作为公共头文件,不能假定其中所有成员函数都是 inline。
3.5 调用并编译:main.cpp
1 | |
在项目根目录执行:
1 | |
输出为:
1 | |
-Ibuild 让实现文件找到生成物,-I. 让生成物内部的 #include "keywords.hpp" 找到项目头文件。两者都需要,因为生成物位于另一个目录。
工程可以额外开启 -Wconversion;本例在 gperf 3.3 与 Clang 23 下会收到生成哈希函数把 size_t 转为 unsigned int 的警告。这里的长度已经受生成查询函数限制,但生成代码未必满足项目所有警告规则。若启用 -Werror,应在生成实现所在的编译单元中处理具体警告,保持手写业务代码的检查严格。
4. std::string_view 的边界为什么重要
std::string_view::data() 不保证以 \0 结尾。例如,上面的 raw 数组只有两个字节;从 "if(x)" 截出的前两个字节,后面则是 (。两者都不能按普通 C 字符串交给 strcmp()。
gperf 默认使用零结尾字符串比较。仅仅传入长度参数,并不会自动让默认比较方式变得适合 string_view。相关配置应区分如下:
| 配置 | 输入要求与比较方式 |
|---|---|
| 默认配置 | 要求输入以 NUL 结尾,实际长度与 len 一致 |
仅 %compare-strncmp | 只读取输入前 len 字节,不要求末尾 NUL;词表不能包含 NUL |
%compare-lengths | 按长度进行二进制比较,可处理含 NUL 的字节序列 |
本例同时写了两个声明。实际起作用的是 %compare-lengths;启用它时 %compare-strncmp 被忽略,生成代码使用 memcmp(),并不是“先调用 strncmp() 再调用 memcmp()”。官方手册:NUL 字节与比较方式
封装函数先处理空输入,让默认构造的 std::string_view 直接返回 std::nullopt。其余输入必须指向至少 text.size() 个有效字节;string_view 是借用,不能在底层字符串销毁后继续使用。
这里没有复制输入,也没有进行大小写转换。IF、if 和 ifdef 都不会匹配 if;空格裁剪、分词等预处理应由调用方完成。
5. 接入 CMake 自动生成
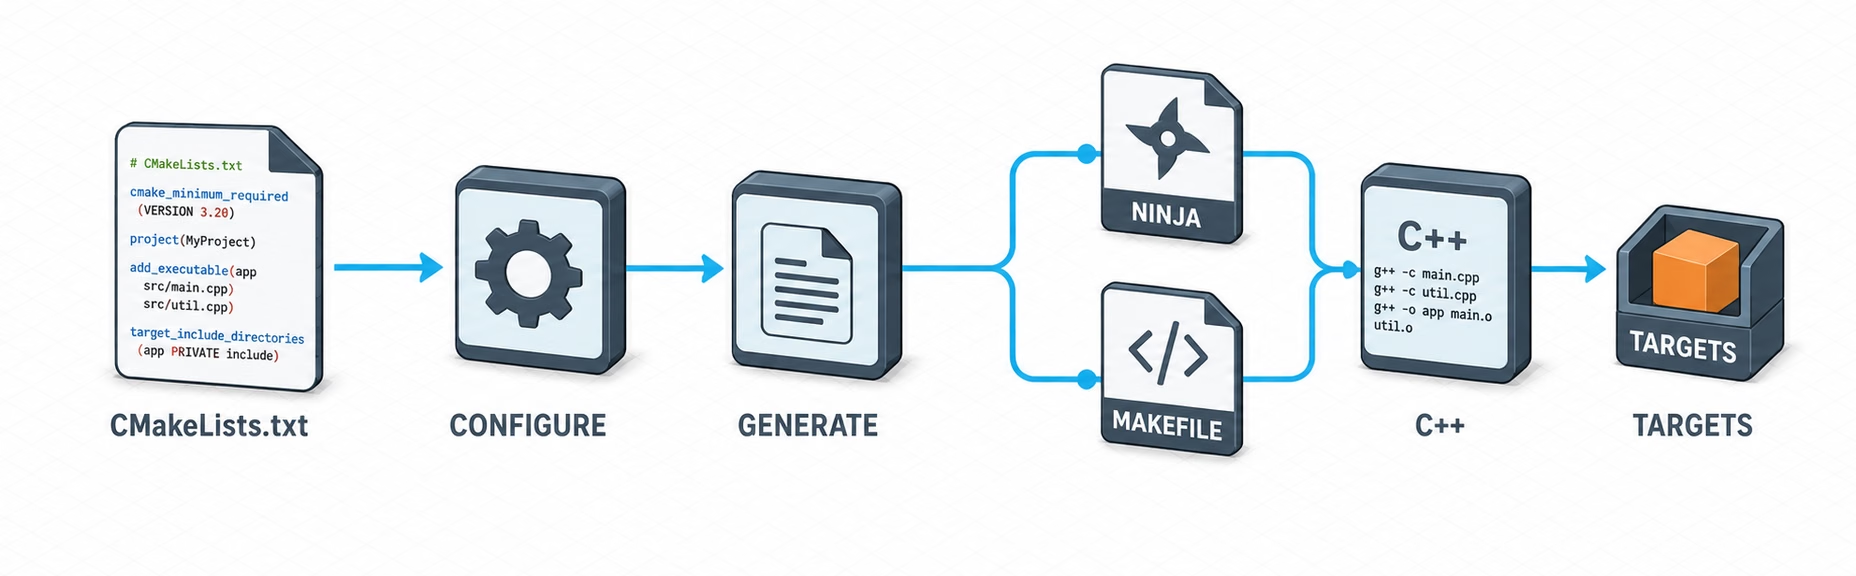
手动执行 gperf 适合学习,工程中应把生成步骤交给构建系统。使用下面的 CMakeLists.txt:
1 | |
这段配置先找到 gperf 并检查版本,然后把词表到生成物的转换声明为构建规则:
OUTPUT指明真正生成的文件,构建系统据此决定是否需要运行 gperf。DEPENDS跟踪词表、业务头文件和生成器。词表或相关定义变更后,重新生成查找器。- 把生成物列入
keywords目标的源文件列表,使首次构建在编译之前先完成生成。它是.inc,由keywords.cpp包含,不会被当成独立源文件编译。 PRIVATE的构建目录只供库实现使用;消费者只需要公开头文件目录和 C++ 标准要求。VERBATIM保证路径中的空格等字符正确传递给构建工具。
这里直接使用 gperf 的 --output-file,避免在 COMMAND 中依赖 shell 的 > 重定向。相关依赖行为见 CMake 官方文档。
构建并运行:
1 | |
上述运行路径适用于单配置生成器;Visual Studio 或 Xcode 等多配置生成器还需要选择配置并使用对应目录。
若有多个 gperf 版本,可以显式指定生成器路径:
1 | |
修改 keywords.gperf 后只需再次构建,无需手动运行 gperf。添加新关键字时,同步维护枚举和测试;不要修改 build/keywords.inc,下一次生成会覆盖它。CI 或交叉编译环境也需要在构建主机上提供 gperf,生成的 C++ 代码再由目标平台的编译器处理。
6. 验证命中和输入边界
查找器最容易遗漏的是“长度相同但内容不同”和“不以 NUL 结尾”的输入。创建 tests.cpp:
1 | |
先按第 3 节生成 build/keywords.inc,再单独编译并运行测试:
1 | |
这是 GCC / Clang 的消毒器用法;其他工具链需要使用各自支持的检查方式。断言全部通过时测试不输出内容;不要定义 NDEBUG,否则 assert 不会执行。
本例没有启用 %7bit。即使词表只有 ASCII,查询输入也可能包含高位字节;只有调用前已经验证全部字节处于 0~127,才适合使用这个优化声明。
7. 常用参数与调优顺序
大多数词表先使用默认算法,不要一开始就手工指定哈希位置。参数既可以写在输入文件中,也可以放在命令行;两边重复配置时,命令行参数优先。
| 参数 | 用途 | 注意事项 |
|---|---|---|
--ignore-case | 忽略 ASCII 字母大小写 | 不提供 Unicode 大小写折叠 |
-m 10 | 尝试更多方案并选择结果 | 增加生成时间,不等于查询快十倍 |
-S 1 | 尝试用一个 switch 组织查询 | 是否更小、更快取决于词表和编译器 |
-k '1,$' | 只选择首字节和末字节参与哈希 | 可能无法区分不同关键字 |
-D | 允许处理哈希值重复的关键字 | 可能增加比较,削弱无冲突查找的性质 |
例如,保留原来的词表配置,增加生成时的搜索次数:
1 | |
-k 的位置从 1 开始,$ 表示末字节。建议交给默认算法选择位置;若生成失败,先检查重复关键字、手工位置限制和大小写折叠后的重名,再考虑调整参数。不要用 -D 掩盖本应消除的词表歧义。官方手册:算法参数
如果一个程序包含多份生成表,应给各表设置不同的类名和表项类型名。把生成代码合并到同一翻译单元时,还需要检查其他生成标识符,避免冲突。
性能判断应覆盖什么
“固定集合查找接近常数时间”主要描述随关键字数量变化的查询步骤,不表示字符串比较与长度无关。内容比较仍可能检查多个字节,不能笼统地把整个操作说成对任意长度都是 O(1)。
基准至少应覆盖命中、未命中、同长度误匹配,以及真实输入中的频率分布,并与简单字符串比较、数组查找和动态哈希表比较。使用相同优化级别,让查询结果参与可观察输出,防止编译器把整个查找消掉;同时检查生成表大小和最终二进制体积。
工程落地时,维护 .gperf 词表和业务接口,让构建系统负责生成,把输入边界交给测试验证。只有测量显示查询收益足以抵消构建和维护成本,再采用 gperf。